Clonage efficace des données dans Kubernetes à l'aide de snapshots de volumes externes
Un guide de 2021 explique comment contourner les restrictions de namespace en important des snapshots du fournisseur cloud comme images dorées pour créer des environnements de développement rapides et isolés.
Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en septembre 2021, Augustinas Stirbis de CAST AI a décrit une méthode pour gérer la duplication de données dans des clusters gourmands en ressources. L'article aborde les goulots d'étranglement liés à la copie de grands jeux de données et propose d'utiliser des VolumeSnapshots pré-provisionnés pour créer efficacement des environnements de développement isolés.
Ce qui s'est passé
Les développeurs ont souvent besoin de copies exactes des données de production pour tester des modifications de schéma ou effectuer des opérations par lots sans mettre en danger les systèmes en direct. Traditionnellement, cela implique de télécharger les données depuis le stockage par blocs vers les nœuds de calcul, puis de les renvoyer vers le stockage. Ce processus consomme beaucoup de bande passante réseau, de CPU et de RAM, entraînant des cycles d'itération lents et des coûts d'infrastructure élevés. L'accélération matérielle peut aider, mais l'inefficacité fondamentale liée au déplacement des données sur le réseau reste un obstacle majeur.
Kubernetes a introduit les VolumeSnapshots pour répondre à ce problème, atteignant la disponibilité générale (General Availability) dans la version 1.20 après avoir commencé comme alpha en 1.12 et beta en 1.17. Ces snapshots exploitent les API des fournisseurs de stockage pour dupliquer les volumes de données. Pour les systèmes sur site, il s'agit souvent d'une opération métadonnée qui pointe un nouveau disque vers un snapshot immuable, ne sauvegardant que les différences. Dans les clouds publics, les snapshots sont stockés dans le stockage objet et recopiés vers le stockage par blocs. Bien que cela utilise toujours des ressources de calcul et réseau côté fournisseur, cela décharge le cluster Kubernetes lui-même, rendant l'opération instantanée aux yeux de l'utilisateur.
Cependant, une limitation de conception existe : les VolumeSnapshots sont limités aux namespaces. Kubernetes empêche les pods d'un namespace de monter des PersistentVolumeClaims (PVC) d'un autre namespace pour assurer l'isolation des locataires. Cela signifie qu'un snapshot créé dans un namespace de production ne peut pas être directement référencé par un namespace de développement. La création de volumes dupliqués dans le même namespace est possible mais risquée, car elle augmente le risque de référencer la mauvaise copie et affaiblit les contrôles d'accès.
Comment cela fonctionne
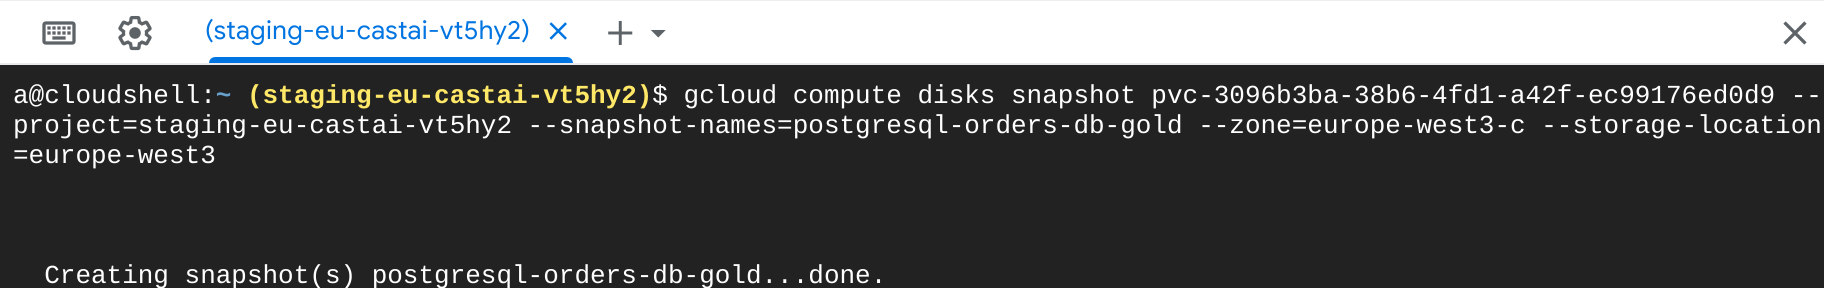
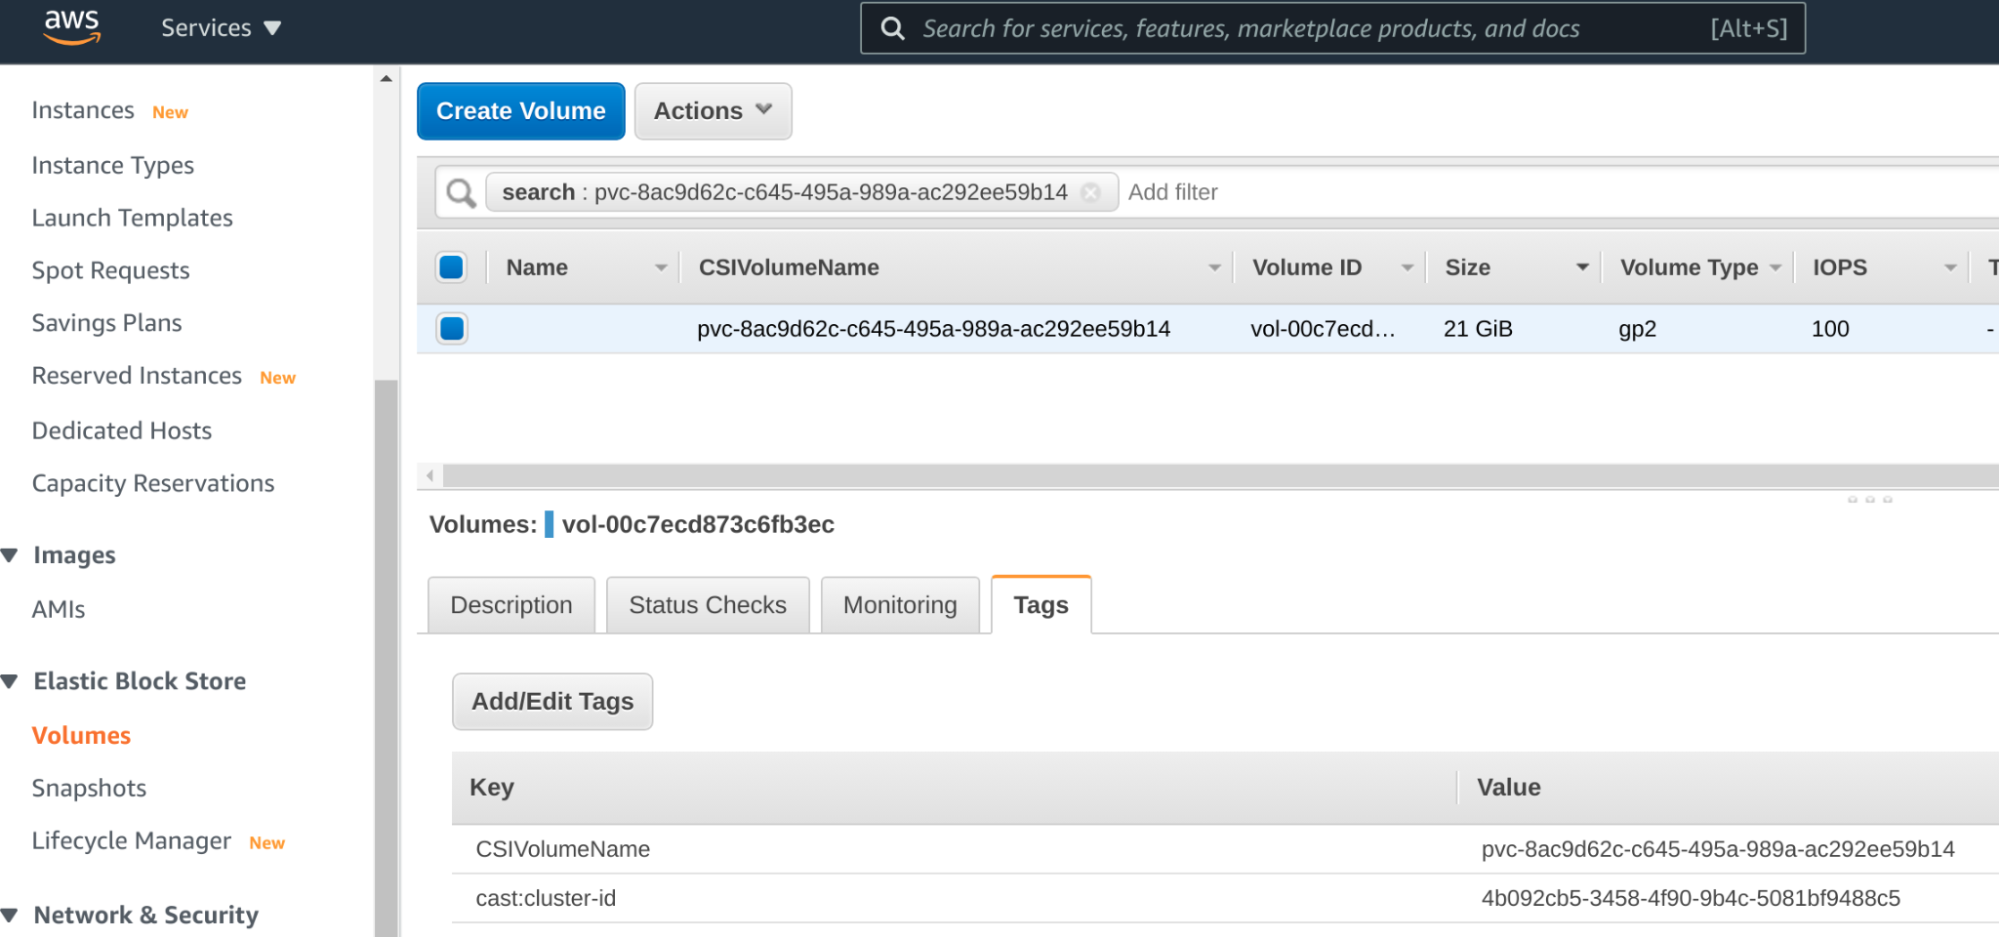
La solution proposée contourne les restrictions de namespace Kubernetes en créant un « golden snapshot » (image dorée) en externe. Au lieu d'utiliser l'API Kubernetes pour prendre le premier snapshot, les administrateurs utilisent les outils du fournisseur cloud pour capturer l'état du disque. Ce snapshot externe est ensuite importé dans Kubernetes sous forme de VolumeSnapshotContent, une ressource de portée cluster non liée à un namespace spécifique. Ce contenu agit comme un pont, permettant à plusieurs namespaces de référencer la même source de données sous-jacente.
Une fois le VolumeSnapshotContent établi, les équipes peuvent créer un VolumeSnapshot dans leur namespace spécifique qui se mappe à ce contenu global. À partir de là, elles génèrent un PersistentVolumeClaim basé sur ce snapshot. Ce PVC peut ensuite être monté par des déploiements ou des stateful sets dans l'environnement de développement. Chaque équipe obtient une copie unique et modifiable des données, tandis que le snapshot doré original reste immuable et partagé efficacement à travers le cluster.
Détails clés
- Les VolumeSnapshots sont devenus généralement disponibles dans Kubernetes version 1.20, ayant progressé à travers les phases alpha en 1.12 et beta en 1.17.
- La duplication de données via les méthodes traditionnelles de téléchargement-téléversement consomme un trafic réseau et des ressources de calcul excessifs par rapport aux snapshots au niveau du stockage.
- Les VolumeSnapshots de Kubernetes sont conçus pour être limités aux namespaces, empêchant le montage direct de PVC entre namespaces pour protéger l'isolation des locataires.
- La solution de contournement consiste à pré-provisionner un snapshot via les outils CLI du fournisseur cloud comme AWS CLI ou gcloud, en dehors de Kubernetes.
- Les administrateurs importent l'ID du snapshot externe en tant que VolumeSnapshotContent, qui est de portée cluster et peut être référencé par n'importe quel namespace.
- Chaque équipe crée un VolumeSnapshot local et un PVC mappés au VolumeSnapshotContent global, garantissant des copies de données identiques mais isolées.
Pourquoi c'est important
Pour les ingénieurs logiciels et les SRE gérant des applications lourdes en données, cette approche réduit considérablement le temps et les coûts associés à la mise en place d'environnements de staging ou de test. En évitant le besoin de déplacer de grands jeux de données sur le réseau à répétition, les équipes peuvent itérer plus rapidement sur les modifications de schéma de base de données et les fonctionnalités intensives en données. Cela s'aligne également avec les meilleures pratiques de sécurité en gardant les namespaces de production verrouillés tout en fournissant aux développeurs des jeux de données réalistes.
Comprendre la distinction entre les ressources limitées aux namespaces comme les VolumeSnapshots et les ressources de portée cluster comme les VolumeSnapshotContent est crucial pour les opérations Kubernetes avancées. Ce modèle démontre comment exploiter les capacités du fournisseur cloud parallèlement aux abstractions Kubernetes pour surmonter les limitations de la plateforme. Il souligne l'importance de savoir quand sortir de l'API Kubernetes pour atteindre des performances et une flexibilité optimales.
Ce que vous pouvez faire
- Identifiez le PersistentVolumeClaim dans votre namespace de production qui sert de source pour votre copie de données dorée.
- Utilisez la console ou le CLI du fournisseur cloud pour créer un snapshot du disque sous-jacent, en notant l'ID du snapshot.
- Créez un manifeste VolumeSnapshotContent dans Kubernetes qui référence l'ID du snapshot externe de votre fournisseur cloud.
- Définissez un VolumeSnapshot dans chaque namespace de développement cible qui se lie au VolumeSnapshotContent de portée cluster.
- Générez un PersistentVolumeClaim dans le namespace de développement en utilisant le VolumeSnapshot local comme source de données.
- Déployez votre application ou votre stateful set de base de données en utilisant le nouveau PVC pour vérifier que le clone de données est accessible et isolé.



