Clonación eficiente de datos en Kubernetes mediante instantáneas externas de volúmenes
Una guía de 2021 explica cómo eludir las restricciones de espacio de nombres importando instantáneas del proveedor de la nube como imágenes doradas para entornos de desarrollo rápidos y aislados.
Traducido automáticamente del original en inglés.
En una publicación en el Blog de Kubernetes de septiembre de 2021, Augustinas Stirbis de CAST AI describió un método para gestionar la duplicación de datos en clústeres con alta demanda de recursos. El artículo aborda los cuellos de botella de rendimiento al copiar grandes conjuntos de datos y propone utilizar VolumeSnapshots preaprovisionados para crear entornos de desarrollo aislados de manera eficiente.
Qué ocurrió
Los desarrolladores a menudo necesitan copias exactas de los datos de producción para probar cambios en el esquema o realizar operaciones masivas sin poner en riesgo los sistemas activos. Tradicionalmente, esto implica descargar datos del almacenamiento de bloques a los nodos de cómputo y volver a subirlos al almacenamiento. Este proceso consume un ancho de banda de red, CPU y RAM significativos, lo que provoca ciclos de iteración lentos y altos costos de infraestructura. La aceleración por hardware puede ayudar, pero la ineficiencia fundamental de mover datos a través de la red sigue siendo un obstáculo importante.
Kubernetes introdujo VolumeSnapshots para abordar esto, alcanzando la disponibilidad general (General Availability) en la versión 1.20 después de comenzar como alpha en la 1.12 y beta en la 1.17. Estas instantáneas aprovechan las API de los proveedores de almacenamiento para duplicar volúmenes de datos. En sistemas locales (on-premise), esto suele ser una operación de metadatos que apunta un nuevo disco a una instantánea inmutable, guardando solo las diferencias. En nubes públicas, las instantáneas se almacenan en almacenamiento de objetos y se copian de vuelta al almacenamiento de bloques. Aunque esto todavía utiliza recursos de cómputo y de red en el lado del proveedor, descarga la carga del propio clúster de Kubernetes, haciendo que la operación parezca instantánea para el usuario.
Sin embargo, existe una limitación de diseño: los VolumeSnapshots están asociados a espacios de nombres (namespaced). Kubernetes impide que los pods en un espacio de nombres monten PersistentVolumeClaims (PVCs) de otro para garantizar el aislamiento entre inquilinos (tenants). Esto significa que una instantánea creada en un espacio de nombres de producción no puede ser referenciada directamente por un espacio de nombres de desarrollo. Crear volúmenes duplicados dentro del mismo espacio de nombres es posible pero arriesgado, ya que aumenta la probabilidad de referenciar la copia incorrecta y debilita los controles de acceso.
Cómo funciona
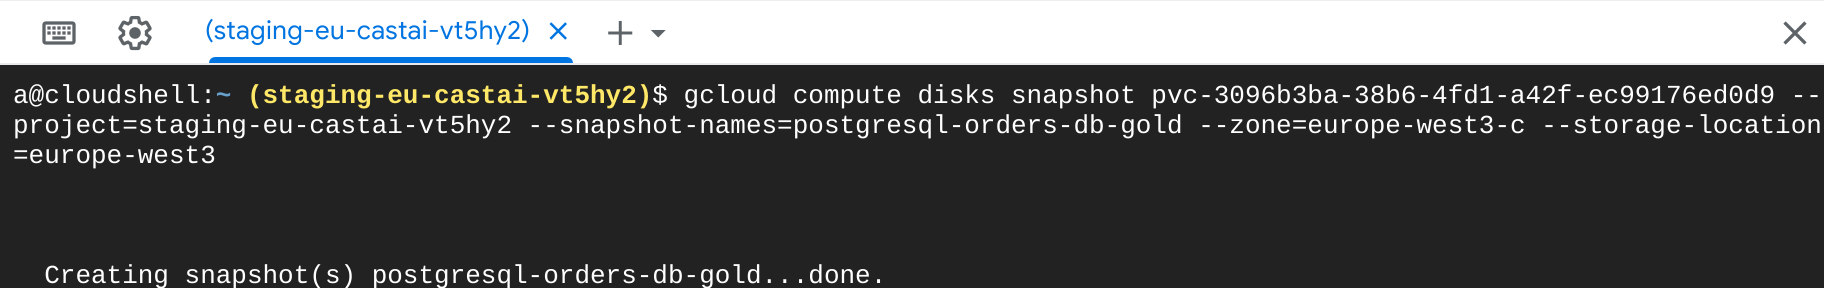
La solución propuesta elude las restricciones de espacios de nombres de Kubernetes creando una "instantánea dorada" externamente. En lugar de usar la API de Kubernetes para tomar la instantánea inicial, los administradores utilizan herramientas del proveedor de la nube para capturar el estado del disco. Esta instantánea externa se importa luego a Kubernetes como un VolumeSnapshotContent, que es un recurso de ámbito de clúster (cluster-scoped) no vinculado a un espacio de nombres específico. Este contenido actúa como puente, permitiendo que múltiples espacios de nombres hagan referencia a la misma fuente de datos subyacente.
Una vez establecido el VolumeSnapshotContent, los equipos pueden crear un VolumeSnapshot dentro de su espacio de nombres específico que se mapee a este contenido global. Desde allí, generan un PersistentVolumeClaim basado en esa instantánea. Este PVC puede ser montado entonces por deployments o stateful sets en el entorno de desarrollo. Cada equipo obtiene una copia única y escribible de los datos, mientras que la instantánea dorada original permanece inmutable y compartida eficientemente a través del clúster.
Detalles clave
- Los VolumeSnapshots se volvieron de Disponibilidad General en la versión 1.20 de Kubernetes, habiendo progresado desde alpha en la 1.12 y beta en la 1.17.
- Duplicar datos mediante métodos tradicionales de descarga-subida consume tráfico de red y recursos de cómputo excesivos en comparación con las instantáneas a nivel de almacenamiento.
- Los VolumeSnapshots de Kubernetes están diseñados para estar asociados a espacios de nombres, lo que previene el montaje directo de PVCs entre espacios de nombres para proteger el aislamiento de inquilinos.
- La alternativa consiste en preaprovisionar una instantánea mediante herramientas CLI del proveedor de la nube como AWS CLI o gcloud, fuera de Kubernetes.
- Los administradores importan el ID de la instantánea externa como un VolumeSnapshotContent, que es de ámbito de clúster y puede ser referenciado por cualquier espacio de nombres.
- Cada equipo crea un VolumeSnapshot local y un PVC mapeados al VolumeSnapshotContent global, asegurando copias de datos aisladas pero idénticas.
Por qué importa
Para ingenieros de software y SREs que gestionan aplicaciones intensivas en datos, este enfoque reduce significativamente el tiempo y el costo asociados con la puesta en marcha de entornos de staging o pruebas. Al evitar la necesidad de mover grandes conjuntos de datos a través de la red repetidamente, los equipos pueden iterar más rápido sobre cambios en el esquema de base de datos y funciones intensivas en datos. También se alinea con las mejores prácticas de seguridad al mantener los espacios de nombres de producción bloqueados mientras aún proporciona a los desarrolladores conjuntos de datos realistas.
Comprender la distinción entre recursos asociados a espacios de nombres como VolumeSnapshots y recursos de ámbito de clúster como VolumeSnapshotContent es crucial para operaciones avanzadas de Kubernetes. Este patrón demuestra cómo aprovechar las capacidades del proveedor de la nube junto con las abstracciones de Kubernetes para superar las limitaciones de la plataforma. Destaca la importancia de saber cuándo salir de la API de Kubernetes para lograr un rendimiento y flexibilidad óptimos.
Qué puedes hacer
- Identifica el PersistentVolumeClaim en tu espacio de nombres de producción que sirve como fuente para tu copia de datos dorada.
- Utiliza la consola o la CLI del proveedor de la nube para crear una instantánea del disco subyacente, anotando el ID de la instantánea.
- Crea un manifiesto de VolumeSnapshotContent en Kubernetes que haga referencia al ID de la instantánea externa de tu proveedor de la nube.
- Define un VolumeSnapshot en cada espacio de nombres de desarrollo objetivo que se vincule al VolumeSnapshotContent de ámbito de clúster.
- Genera un PersistentVolumeClaim en el espacio de nombres de desarrollo utilizando el VolumeSnapshot local como fuente de datos.
- Despliega tu aplicación o stateful set de base de datos usando el nuevo PVC para verificar que la clonación de datos sea accesible y esté aislada.



