Effizientes Klonen von Daten in Kubernetes mit externen Volume-Snapshots
Ein Leitfaden aus dem Jahr 2021 erklärt, wie man Namespace-Einschränkungen umgeht, indem Snapshots des Cloud-Anbieters als Golden Images für schnelle, isolierte Entwicklungsumgebungen importiert werden.
Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Kubernetes Blog im September 2021 skizzierte Augustinas Stirbis von CAST AI eine Methode zur Handhabung von Datenreplikation in ressourcenintensiven Clustern. Der Artikel befasst sich mit den Performance-Engpässen beim Kopieren großer Datensätze und schlägt vor, vorab bereitgestellte VolumeSnapshots zu nutzen, um isolierte Entwicklungsumgebungen effizient zu erstellen.
Was passiert ist
Entwickler benötigen oft exakte Kopien der Produktionsdaten, um Schemaänderungen zu testen oder Bulk-Operationen durchzuführen, ohne Live-Systeme zu gefährden. Traditionell umfasst dies das Herunterladen von Daten vom Blockspeicher auf die Compute-Knoten und das anschließende Hochladen zurück in den Speicher. Dieser Prozess verbraucht erhebliche Netzwerkbandbreite, CPU und RAM, was zu langsamen Iterationszyklen und hohen Infrastrukturkosten führt. Hardware-Beschleunigung kann helfen, aber die grundlegende Ineffizienz bei der Bewegung von Daten über das Netzwerk bleibt ein großes Hindernis.
Kubernetes hat VolumeSnapshots eingeführt, um dieses Problem anzugehen; sie erreichten in Version 1.20 den Status General Availability, nachdem sie in 1.12 als Alpha und in 1.17 als Beta gestartet waren. Diese Snapshots nutzen die APIs der Speicheranbieter, um Datenvolumes zu duplizieren. Bei On-Premise-Systemen handelt es sich oft um eine Metadatenoperation, die eine neue Festplatte auf einen unveränderlichen Snapshot verweist und nur die Unterschiede speichert. In öffentlichen Clouds werden Snapshots im Objektspeicher abgelegt und zurück in den Blockspeicher kopiert. Zwar nutzt dies weiterhin Rechen- und Netzwerkressourcen auf Seiten des Anbieters, entlastet jedoch den Kubernetes-Cluster selbst, sodass die Operation für den Benutzer augenblicklich erscheint.
Es gibt jedoch eine Designeinschränkung: VolumeSnapshots sind namespacebezogen. Kubernetes verhindert, dass Pods in einem Namespace PersistentVolumeClaims (PVCs) in einem anderen Namespace mounten, um die Mandantenisolation sicherzustellen. Das bedeutet, dass ein Snapshot, der in einem Produktions-Namespace erstellt wurde, nicht direkt von einem Entwicklungs-Namespace referenziert werden kann. Das Erstellen duplizierter Volumes innerhalb desselben Namespaces ist möglich, aber riskant, da es die Wahrscheinlichkeit erhöht, auf die falsche Kopie zu verweisen, und die Zugriffskontrollen schwächt.
Wie es funktioniert
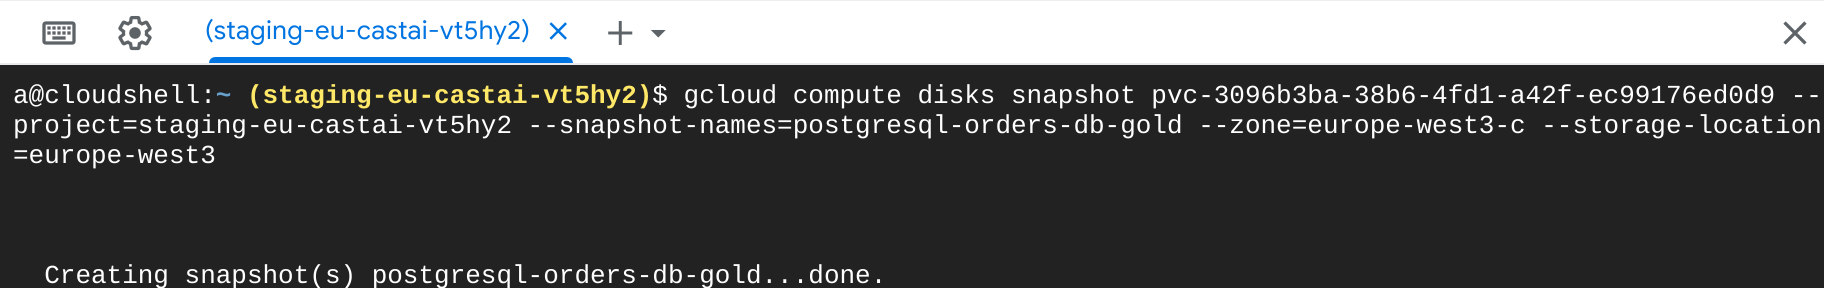
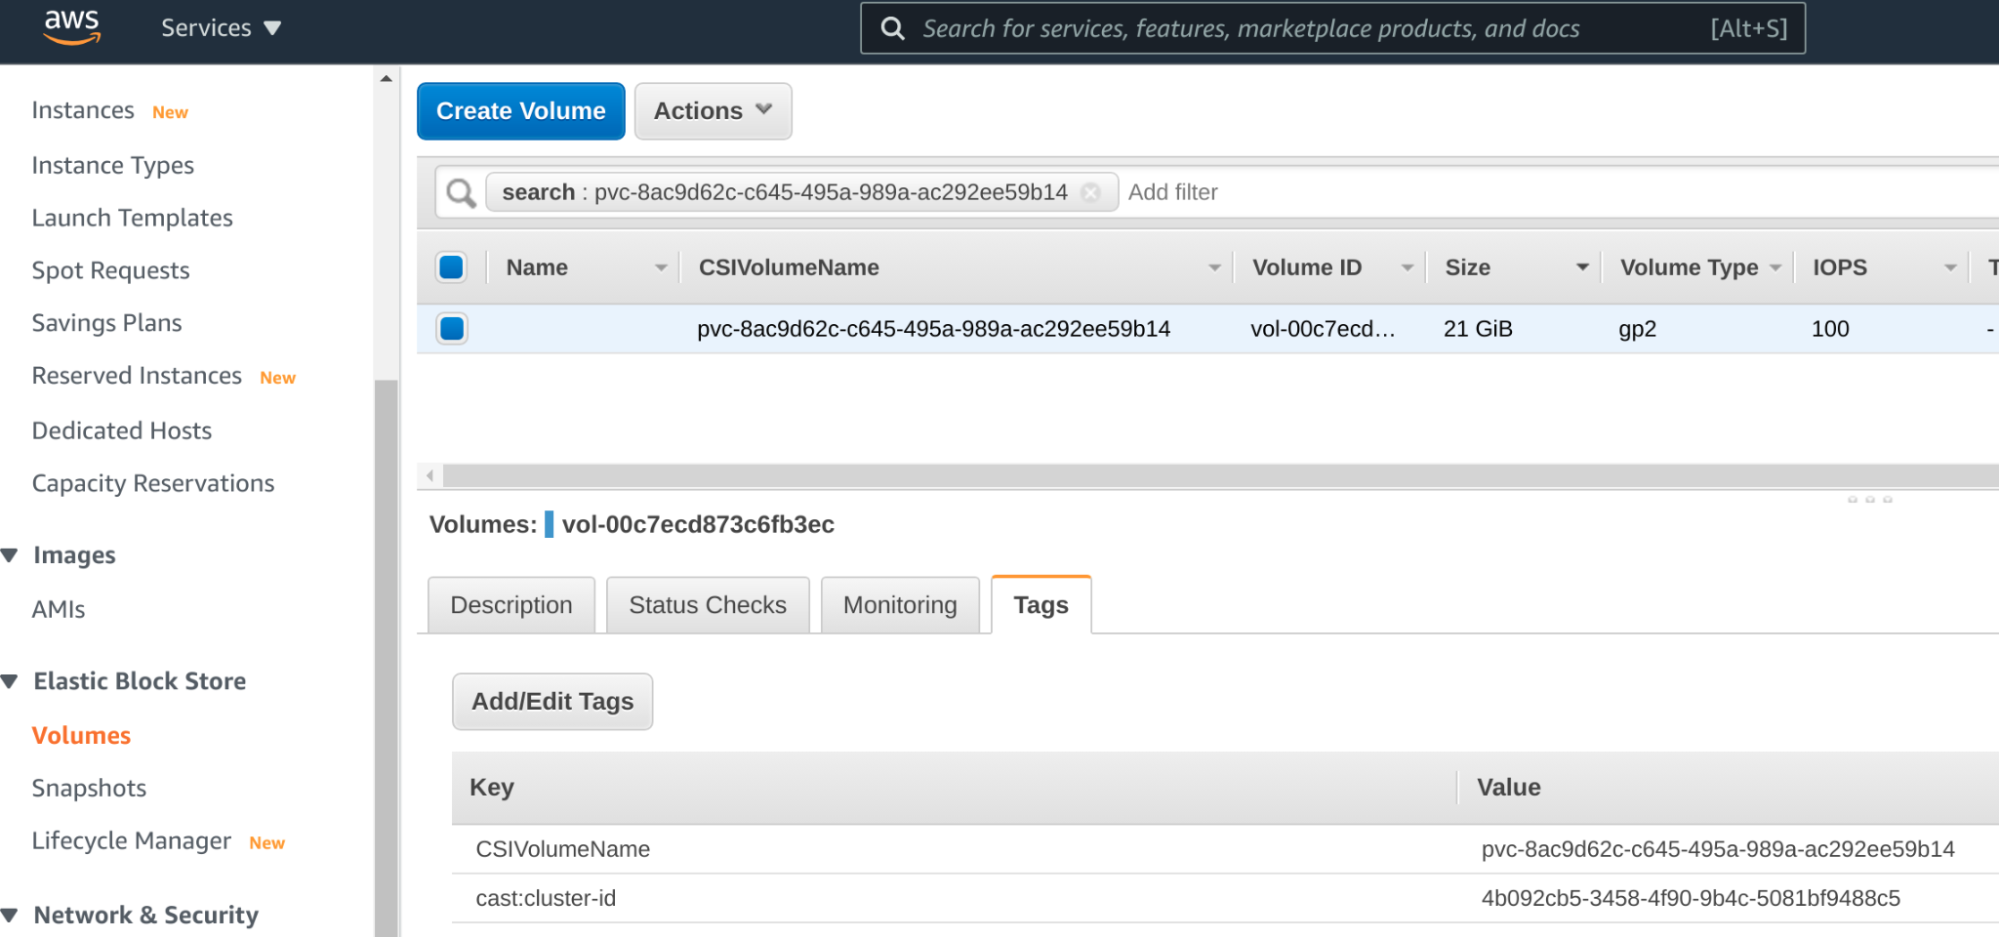
Die vorgeschlagene Lösung umgeht die Kubernetes-Namespace-Einschränkungen, indem ein „Golden Snapshot“ extern erstellt wird. Anstatt die Kubernetes-API für den ersten Snapshot zu verwenden, nutzen Administratoren Tools des Cloud-Anbieters, um den Zustand der Festplatte festzuhalten. Dieser externe Snapshot wird dann als VolumeSnapshotContent in Kubernetes importiert, eine Cluster-scope-Ressource, die nicht an einen bestimmten Namespace gebunden ist. Dieser Content fungiert als Brücke, die es mehreren Namespaces ermöglicht, auf dieselbe zugrunde liegende Datenquelle zu verweisen.
Sobald der VolumeSnapshotContent eingerichtet ist, können Teams einen VolumeSnapshot innerhalb ihres spezifischen Namespaces erstellen, der diesem globalen Content zugeordnet ist. Von dort aus generieren sie einen PersistentVolumeClaim basierend auf diesem Snapshot. Dieser PVC kann dann von Deployments oder Stateful Sets in der Entwicklungsumgebung gemountet werden. Jedes Team erhält eine eindeutige, beschreibbare Kopie der Daten, während der ursprüngliche Golden Snapshot unveränderlich bleibt und effizient im gesamten Cluster geteilt wird.
Wichtige Details
- VolumeSnapshots wurden in Kubernetes Version 1.20 Generally Available, nachdem sie den Weg von Alpha in 1.12 bis Beta in 1.17 durchlaufen hatten.
- Das Duplizieren von Daten über herkömmliche Download-Upload-Methoden verbraucht im Vergleich zu Storage-Level-Snapshots übermäßigen Netzwerkverkehr und Rechenressourcen.
- Kubernetes VolumeSnapshots sind per Design namespacebezogen, was direkte Cross-Namespace-PVC-Mounts zum Schutz der Mandantenisolation verhindert.
- Der Workaround beinhaltet die Vorabbereitstellung eines Snapshots über CLI-Tools des Cloud-Anbieters wie AWS CLI oder gcloud, außerhalb von Kubernetes.
- Administratoren importieren die externe Snapshot-ID als VolumeSnapshotContent, der clusterweit gültig ist und von jedem Namespace referenziert werden kann.
- Jedes Team erstellt einen lokalen VolumeSnapshot und PVC, der dem globalen VolumeSnapshotContent zugeordnet ist, um isolierte, aber identische Datenkopien sicherzustellen.
Warum es wichtig ist
Für Software-Ingenieure und SREs, die datenintensive Anwendungen verwalten, reduziert dieser Ansatz die Zeit und Kosten erheblich, die mit dem Aufbau von Staging- oder Testumgebungen verbunden sind. Durch die Vermeidung wiederholter Bewegungen großer Datensätze über das Netzwerk können Teams schneller an Datenbank-Schemaänderungen und datenintensiven Funktionen iterieren. Es entspricht zudem Sicherheitsbest Practices, indem Produktions-Namespaces gesperrt bleiben, während Entwickler dennoch realistische Datensätze erhalten.
Das Verständnis der Unterscheidung zwischen namespacebezogenen Ressourcen wie VolumeSnapshots und clusterweiten Ressourcen wie VolumeSnapshotContent ist für fortgeschrittene Kubernetes-Operationen entscheidend. Dieses Muster zeigt, wie man die Fähigkeiten des Cloud-Anbieters neben Kubernetes-Abstraktionen nutzt, um Plattformbeschränkungen zu überwinden. Es unterstreicht die Bedeutung zu wissen, wann man die Kubernetes-API verlassen muss, um optimale Leistung und Flexibilität zu erzielen.
Was Sie tun können
- Identifizieren Sie den PersistentVolumeClaim in Ihrem Produktions-Namespace, der als Quelle für Ihre Golden-Datenkopie dient.
- Nutzen Sie die Konsole oder das CLI des Cloud-Anbieters, um einen Snapshot der zugrunde liegenden Festplatte zu erstellen, und notieren Sie die Snapshot-ID.
- Erstellen Sie ein VolumeSnapshotContent-Manifest in Kubernetes, das die externe Snapshot-ID Ihres Cloud-Anbieters referenziert.
- Definieren Sie einen VolumeSnapshot in jedem Ziel-Entwicklungs-Namespace, der an den clusterweiten VolumeSnapshotContent bindet.
- Generieren Sie einen PersistentVolumeClaim im Entwicklungs-Namespace unter Verwendung des lokalen VolumeSnapshots als Datenquelle.
- Stellen Sie Ihre Anwendung oder Ihr Datenbank-Stateful Set mit dem neuen PVC bereit, um zu überprüfen, ob die Datenklonierung zugänglich und isoliert ist.



