Trillionen-Parameter-LLMs auf Mac-Studio-Clustern mit MLX ausführen
Apple-Forscher demonstrieren, wie das 816B Muse Spark Open Modell über vier Mac Studios hinweg unter Verwendung von MLX und RDMA über Thunderbolt ausgeführt wird.
Automatisch aus dem englischen Original übersetzt.
Die Apple Machine Learning Research hat eine technische Tiefenanalyse veröffentlicht, die zeigt, wie Frontier-Klasse-Großsprachmodelle lokal auf Apple Silicon ausgeführt werden können. Der am 15. Oktober 2026 veröffentlichte Bericht erläutert, wie das Open-Source-Framework MLX Unified Memory und neue Netzwerk-Treiber nutzt, um Modelle mit nahezu einer Billion Parameter zu verarbeiten.
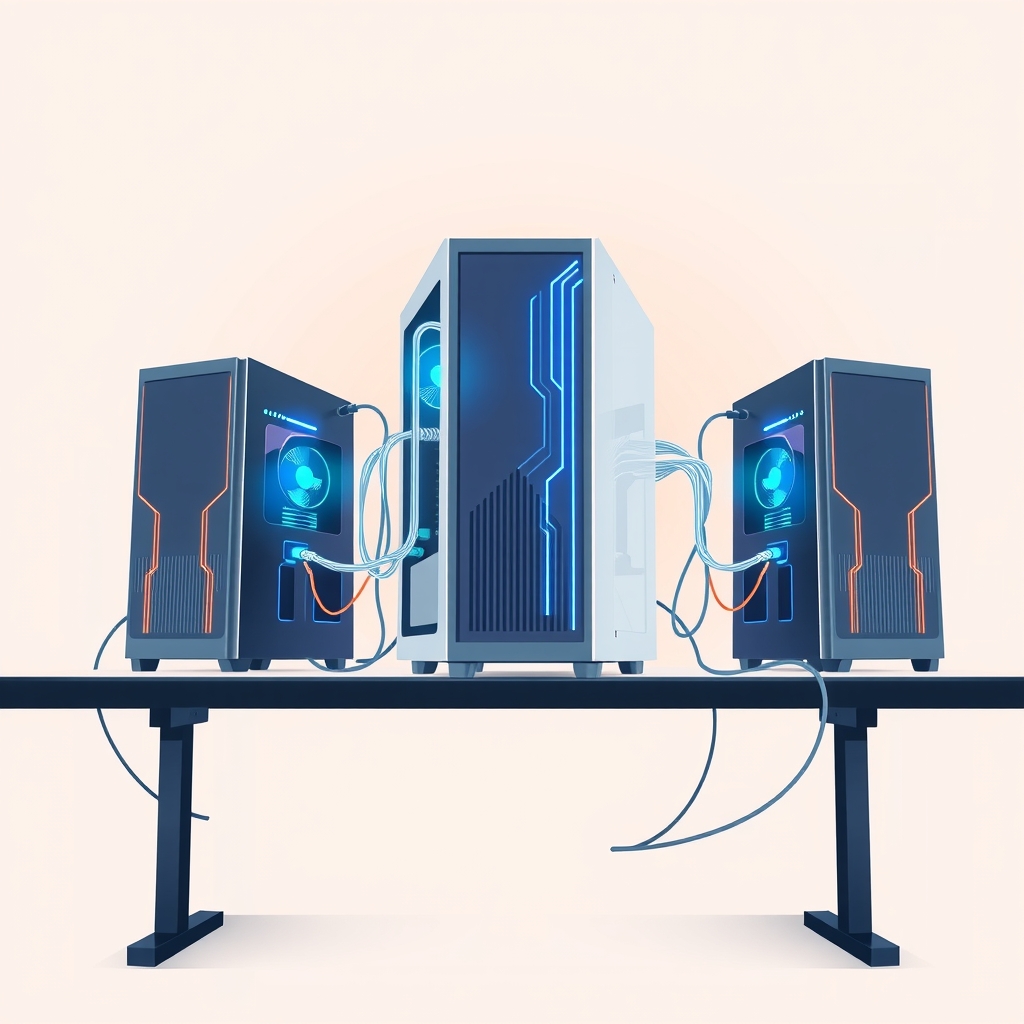
Das Team konnte das Muse Spark Open Modell, das 816 Milliarden Parameter umfasst, erfolgreich auf einem Cluster aus vier Mac Studio Computern ausführen. Durch den Einsatz von Pipeline- und Tensor-Parallelisierungsstrategien über Thunderbolt-Verbindungen erzielten sie Generierungsgeschwindigkeiten, die die menschliche Lesegeschwindigkeit überschreiten, bei gleichzeitig geringem Stromverbrauch.
Was geschah
Die Forschung konzentriert sich auf die Fähigkeiten des neu veröffentlichten M5 Ultra Chips und der neuesten Version des MLX Array Frameworks. Frühere Arbeiten hatten die GPU Neural Accelerators in der M5-Architektur hervorgehoben, aber dieser Beitrag demonstriert praktische Inferenz-Leistung für massive Modelle. Die Autoren verglichen drei spezifische Modelle im Benchmark: Muse Spark Open (816B Parameter), Mistral Medium 3.5 (128B Parameter) und Qwen 3.8 (27B Parameter).
Auf einem einzelnen Mac Studio mit 512GB Unified Memory passen die kleineren dichten Modelle problemlos hinein. Das Muse Spark Open Modell erfordert jedoch deutlich mehr Speicher. Selbst in 4-Bit NVFP4-Präzision beträgt der Speicherbedarf des Modells etwa 493GB, was kaum Spielraum für Zwischenberechnungen lässt. Um dies zu lösen, verteilten die Forscher die Arbeitslast über mehrere Maschinen hinweg unter Verwendung von Remote Direct Memory Access (RDMA) über Thunderbolt 5, einer Funktion, die in macOS 26.2 eingeführt wurde.
Die Benchmarks maßen die Zeit bis zum ersten Token (TTFT), den Generierungsdurchsatz und den Spitzenstromverbrauch. Für das größte Modell nutzte das Team einen Cluster aus vier Mac Studios, die über Thunderbolt-Kabel verbunden waren. Dieses Setup ermöglichte es ihnen, die Schichten oder Gewichte des Modells auf die Geräte aufzuteilen, wodurch eine Inferenz möglich wurde, die auf Desktop-Hardware sonst nicht durchführbar wäre.
Wie es funktioniert
MLX verwendet zwei primäre Strategien, um große Modelle über mehrere Computer hinweg zu verteilen: Pipeline-Parallelisierung und Tensor-Parallelisierung. Die Pipeline-Parallelisierung teilt das Modell nach Tiefe auf, was bedeutet, dass eine Maschine die erste Hälfte der neuronalen Netzwerkschichten verarbeitet und die Ausgabe an die zweite Maschine für die verbleibenden Schichten sendet. Dieser Ansatz ist einfach zu implementieren und verursacht geringen Kommunikations-Overhead, da nur Zwischenwerte zwischen den Knoten ausgetauscht werden.
Die Tensor-Parallelisierung teilt das Modell nach Breite auf und verteilt Bruchteile jeder Schicht auf alle Maschinen. Diese Methode ermöglicht eine höhere Rechenparallelität, erfordert jedoch häufige Kommunikation für jedes Token und jede Schicht. Um dies praktikabel zu machen, stützt sich MLX auf jaccl, eine Reihe von Kommunikationskollektiven, die auf dem latenzarmen RDMA-over-Thunderbolt-Treiber aufgebaut sind. Dies stellt sicher, dass die kleinen, häufigen Datenaustausche, die für die Tensor-Parallelisierung erforderlich sind, nicht zum Engpass werden.
Der M5 Ultra Chip spielt in dieser Architektur eine entscheidende Rolle. Seine GPU Neural Accelerators bieten dedizierte Hardware für Matrixmultiplikationen, was rechenintensive Aufgaben wie die Berechnung der Zeit bis zum ersten Token beschleunigt. Darüber hinaus bietet der M5 Ultra 1,2 TB/s Unified-Memory-Bandbreite, eine erhebliche Steigerung gegenüber den 819 GB/s des vorherigen M3 Ultra. Diese Bandbreite verbessert direkt die Generierungsgeschwindigkeit, die speicherlimitiert ist.
Wichtige Details
- Muse Spark Open ist ein Mixture-of-Experts-Modell mit 816 Milliarden Parametern, das in NVFP4-Präzision evaluiert wurde, wobei während der Inferenz nur 42 Milliarden Parameter aktiv sind.
- Ein Cluster aus vier Mac Studios mit M5 Ultra Chips erreichte über 36 Tokens pro Sekunde für Muse Spark Open bei einer Kontextgröße von 8.192 Tokens.
- Der M5 Ultra liefert bis zu 4,6-mal schnellere Zeit bis zum ersten Token im Vergleich zum M3 Ultra für rechenlimitierte Workloads dank der GPU Neural Accelerators.
- Der Spitzenstromverbrauch für LLM-Inferenz auf einem Mac Studio mit M5 Ultra liegt bei etwa 300 Watt, deutlich niedriger als bei vielen Server-Alternativen.
- MLX v0.30.1 und später unterstützt
jacclfür RDMA über Thunderbolt, was latenzarme Kommunikation zwischen Mac Studio Einheiten ermöglicht. - Die Pipeline-Parallelisierung kann beim Prefilling sehr großer Kontexte (65.536 Tokens) bis zu 1,8-mal schneller sein als ein einzelner Knoten, indem Berechnungsblöcke über die Maschinen hinweg überlappt werden.
Warum es wichtig ist
Für Software-Ingenieure und KI-Forscher senkt diese Entwicklung die Hürde für Experimente mit Frontier-Klasse-Modellen. Die lokale Ausführung eines Modells mit 816 Milliarden Parametern bedeutet, dass Daten niemals die private Umgebung verlassen, was signifikante Datenschutz- und Sicherheitsbedenken im Zusammenhang mit Cloud-basierten APIs adressiert. Es ermöglicht zudem schnelle Iterationen bei Fine-Tuning- und Inferenzmethoden, ohne auf die Zuteilung von Cloud-Ressourcen warten oder Ausstiegskosten tragen zu müssen.
Die Effizienz von Apple Silicon verändert auch die Wirtschaftlichkeit lokaler KI-Infrastruktur. Mit einem Spitzenstromverbrauch von rund 300 Watt kann ein Mac Studio in Standard-Büro- oder Heimumgebungen betrieben werden, ohne dass spezielle Kühl- oder Strominfrastrukturen erforderlich sind. Dies macht es für kleine Teams oder einzelne Entwickler machbar, leistungsstarke Inferenz-Cluster zu betreiben, die sowohl kraftvoll als auch energieeffizient sind.
Darüber hinaus ist die Unterstützung für große Kontextfenster entscheidend für agentische Workflows. Coding-Assistenten und komplexe Reasoning-Agenten erfordern oft Kontextgrößen von 65.536 Tokens oder mehr. Die Fähigkeit, diese großen Kontexte schnell auf lokaler Hardware zu verarbeiten, ermöglicht anspruchsvollere autonome Agenten, die gesamte Codebasen oder lange Dokumente in Echtzeit verstehen können.
Was Sie tun können
- Installieren Sie die neueste Version von MLX (v0.30.1 oder später), um Zugriff auf die Unterstützung für RDMA über Thunderbolt und das
jacclBackend zu erhalten. - Verwenden Sie das Tool
mlx_lm.benchmark, um die Zeit bis zum ersten Token und den Durchsatz für Ihre spezifischen Modelle und Kontextgrößen zu messen. - Verbinden Sie mehrere Mac Studio Einheiten mit jeweils zwei Thunderbolt-Kabeln pro Paar, um die Link-Bandbreite für verteilte Inferenz zu verdoppeln.
- Experimentieren Sie mit Pipeline-Parallelisierung für ein einfacheres Setup und geringen Kommunikations-Overhead, wenn Sie Modelle auf zwei Maschinen aufteilen.
- Nutzen Sie Tensor-Parallelisierung über vier Maschinen für maximale Rechenparallelität, stellen Sie jedoch sicher, dass Sie das Thunderbolt-Mesh korrekt konfigurieren.
- Aktivieren Sie die Umgebungsvariable
MLX_METAL_FAST_SYNCH=1, um den Kommunikations-Overhead zwischen CPU und GPU während verteilter Jobs zu reduzieren.