Ejecutar LLMs de un billón de parámetros en clústeres de Mac Studio con MLX
Investigadores de Apple demuestran cómo ejecutar el modelo abierto Muse Spark de 816B en cuatro Mac Studios utilizando MLX y RDMA sobre Thunderbolt.
Traducido automáticamente del original en inglés.
Apple Machine Learning Research ha publicado un análisis técnico detallado que muestra cómo ejecutar modelos de lenguaje grandes (LLM) de clase frontera localmente en Apple Silicon. Publicado el 15 de octubre de 2026, el informe detalla cómo el framework de código abierto MLX aprovecha la memoria unificada y los nuevos controladores de red para manejar modelos con casi un billón de parámetros.
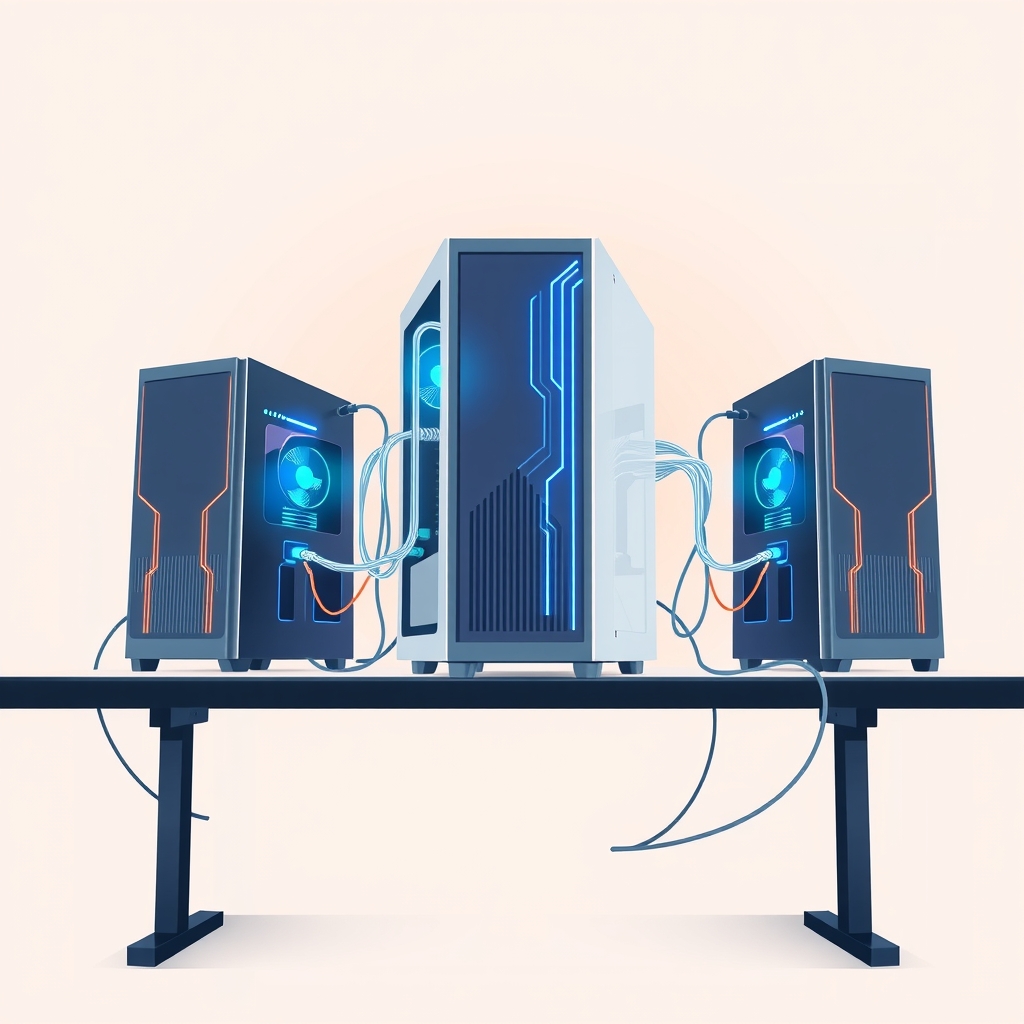
El equipo logró ejecutar con éxito el modelo Muse Spark Open, que contiene 816 mil millones de parámetros, en un clúster de cuatro computadoras Mac Studio. Mediante el uso de estrategias de paralelización de tubería (pipeline) y de tensores a través de conexiones Thunderbolt, alcanzaron velocidades de generación superiores a la tasa de lectura humana mientras mantenían un bajo consumo energético.
Qué ocurrió
La investigación se centra en las capacidades del recién lanzado chip M5 Ultra y la última versión del framework de matrices MLX. Trabajos anteriores destacaron los Aceleradores Neuronales de GPU en la arquitectura M5, pero esta publicación demuestra el rendimiento práctico de inferencia para modelos masivos. Los autores realizaron pruebas de referencia (benchmarks) de tres modelos específicos: Muse Spark Open (816B de parámetros), Mistral Medium 3.5 (128B de parámetros) y Qwen 3.8 (27B de parámetros).
En un solo Mac Studio con 512GB de memoria unificada, los modelos densos más pequeños caben cómodamente. Sin embargo, Muse Spark Open requiere significativamente más memoria. Incluso en precisión NVFP4 de 4 bits, la huella del modelo es de aproximadamente 493GB, dejando poco espacio para cálculos intermedios. Para resolver esto, los investigadores distribuyeron la carga de trabajo entre múltiples máquinas utilizando Acceso Directo a Memoria Remota (RDMA) sobre Thunderbolt 5, una característica introducida en macOS 26.2.
Las pruebas midieron el tiempo hasta el primer token (TTFT), el rendimiento de generación y el pico de consumo energético. Para el modelo más grande, el equipo utilizó un clúster de cuatro Mac Studios conectados mediante cables Thunderbolt. Esta configuración les permitió dividir las capas o pesos del modelo entre dispositivos, habilitando una inferencia que de otro modo sería imposible en hardware de escritorio.
Cómo funciona
MLX utiliza dos estrategias principales para distribuir modelos grandes entre múltiples computadoras: paralelización de tubería y paralelización de tensores. La paralelización de tubería divide el modelo por profundidad, lo que significa que una máquina maneja la primera mitad de las capas de la red neuronal y envía la salida a la segunda máquina para las capas restantes. Este enfoque es simple de implementar y tiene una baja sobrecarga de comunicación porque solo se intercambian salidas intermedias entre los nodos.
La paralelización de tensores divide el modelo por ancho, distribuyendo fracciones de cada capa entre todas las máquinas. Este método permite un mayor paralelismo de cómputo, pero requiere comunicación frecuente para cada token y capa. Para hacer esto viable, MLX depende de jaccl, un conjunto de operaciones colectivas de comunicación construido sobre el controlador de baja latencia RDMA-over-Thunderbolt. Esto asegura que los intercambios de datos pequeños y frecuentes requeridos por la paralelización de tensores no se conviertan en un cuello de botella.
El chip M5 Ultra juega un papel crítico en esta arquitectura. Sus Aceleradores Neuronales de GPU proporcionan hardware dedicado para la multiplicación de matrices, lo que acelera tareas limitadas por el cómputo como calcular el tiempo hasta el primer token. Además, el M5 Ultra ofrece 1.2 TB/s de ancho de banda de memoria unificada, un aumento significativo respecto a los 819 GB/s disponibles en el anterior M3 Ultra. Este ancho de banda mejora directamente la velocidad de generación, que está limitada por la memoria.
Detalles clave
- Muse Spark Open es un modelo de mezcla de expertos (mixture of experts) de 816 mil millones de parámetros evaluado en precisión NVFP4, con solo 42 mil millones de parámetros activos durante la inferencia.
- Un clúster de cuatro Mac Studios con chips M5 Ultra logró más de 36 tokens por segundo para Muse Spark Open con un tamaño de contexto de 8,192 tokens.
- El M5 Ultra ofrece hasta 4.6× más rápido el tiempo hasta el primer token en comparación con el M3 Ultra para cargas de trabajo limitadas por el cómputo debido a los Aceleradores Neuronales de GPU.
- El pico de consumo energético para la inferencia de LLM en un Mac Studio con M5 Ultra es de aproximadamente 300 vatios, significativamente menor que muchas alternativas de grado servidor.
- MLX v0.30.1 y versiones posteriores soportan
jacclpara RDMA sobre Thunderbolt, permitiendo comunicación de baja latencia entre unidades Mac Studio. - La paralelización de tubería puede ser hasta 1.8× más rápida que un solo nodo para el prellenado (prefilling) de contextos muy grandes (65,536 tokens) al superponer fragmentos de cómputo entre máquinas.
Por qué importa
Para ingenieros de software e investigadores de IA, este desarrollo reduce la barrera para experimentar con modelos de clase frontera. Ejecutar un modelo de 816 mil millones de parámetros localmente significa que los datos nunca abandonan el entorno privado, abordando importantes preocupaciones de privacidad y seguridad asociadas con las APIs basadas en la nube. También permite iterar rápidamente en métodos de ajuste fino (fine-tuning) e inferencia sin esperar la asignación de recursos en la nube ni lidiar con costos de egreso.
La eficiencia de Apple Silicon también cambia la economía de la infraestructura de IA local. Con un pico de consumo energético alrededor de 300 vatios, un Mac Studio puede operar en entornos de oficina o hogar estándar sin necesidad de refrigeración especializada o infraestructura eléctrica. Esto hace factible que equipos pequeños o desarrolladores individuales mantengan clústeres de inferencia de alto rendimiento que son tanto potentes como energéticamente eficientes.
Además, el soporte para ventanas de contexto grandes es crucial para flujos de trabajo agénticos. Los asistentes de codificación y los agentes de razonamiento complejo a menudo requieren tamaños de contexto de 65,536 tokens o más. La capacidad de procesar estos contextos grandes rápidamente en hardware local habilita agentes autónomos más sofisticados que pueden entender bases de código completas o documentos extensos en tiempo real.
Qué puedes hacer
- Instala la última versión de MLX (v0.30.1 o posterior) para acceder al soporte para RDMA sobre Thunderbolt y el backend
jaccl. - Utiliza la herramienta
mlx_lm.benchmarkpara medir el tiempo hasta el primer token y el rendimiento para tus modelos específicos y tamaños de contexto. - Conecta múltiples unidades Mac Studio con dos cables Thunderbolt por par para duplicar el ancho de banda del enlace para la inferencia distribuida.
- Experimenta con la paralelización de tubería para una configuración más simple y baja sobrecarga de comunicación al dividir modelos entre dos máquinas.
- Usa la paralelización de tensores en cuatro máquinas para máximo paralelismo de cómputo, asegurándote de configurar correctamente la malla Thunderbolt.
- Habilita la variable de entorno
MLX_METAL_FAST_SYNCH=1para reducir la sobrecarga de comunicación entre CPU y GPU durante trabajos distribuidos.