vLLM: Push-basierte KV-Übertragung senkt Latenz bei disaggregierter Inferenz
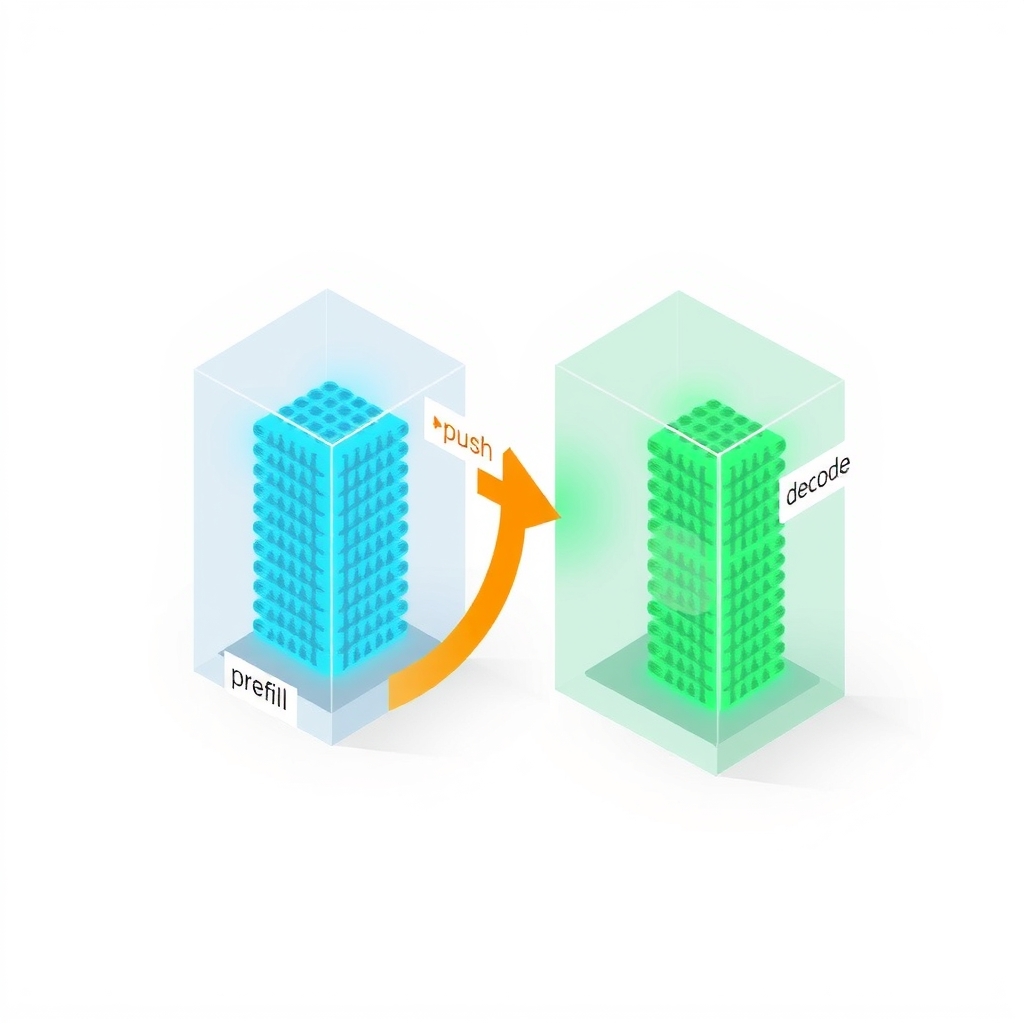
Ein neuer push-basierter Connector für vLLM reduziert die Zeit bis zum ersten Token (Time-to-First-Token) in disaggregierten Prefill-Decode-Setups auf AWS um bis zu das Dreifache.