vLLMのプッシュ型KV転送、分離推論におけるレイテンシを削減
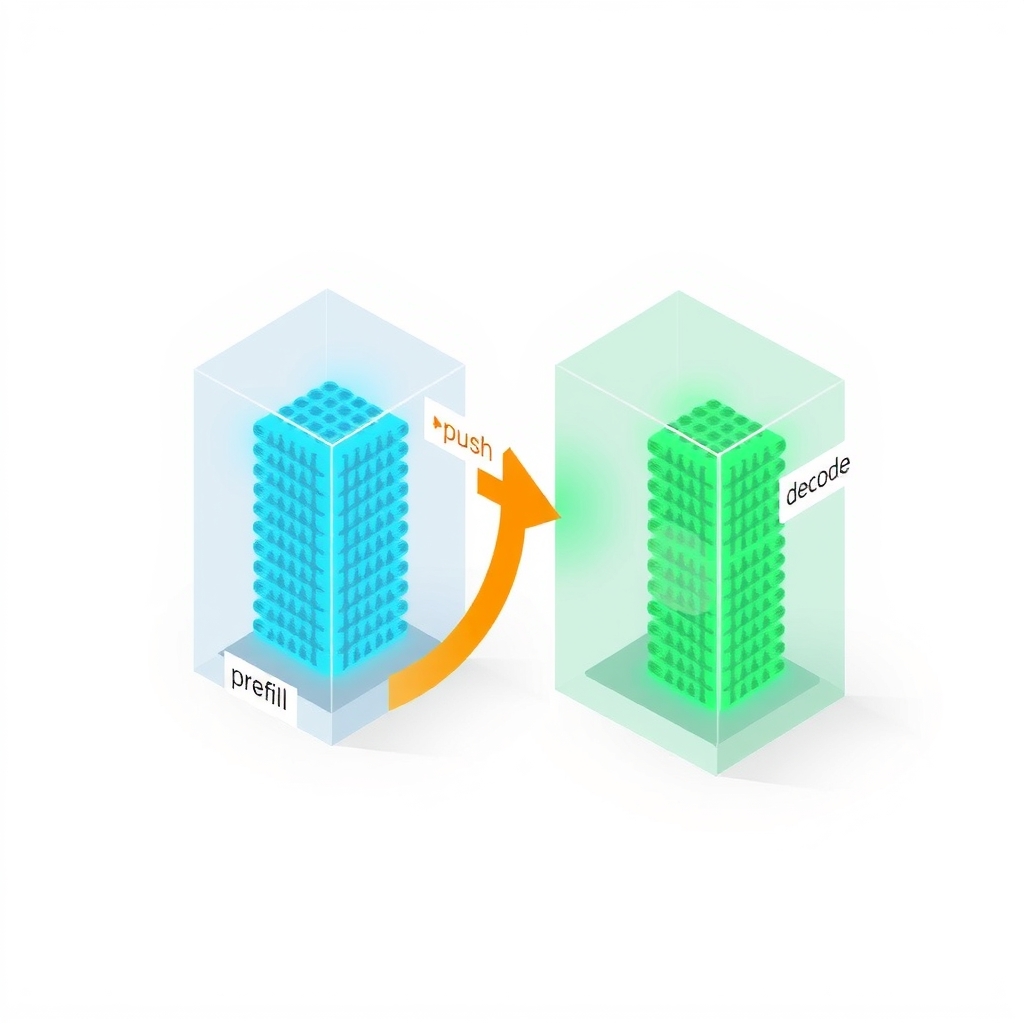
vLLM向けの新しいプッシュ型コネクタにより、AWS上の分離プリフィル・デコード構成において、最初のトークン生成までの時間(TTFT)が最大3倍短縮されます。
RAG、評価、推論、ファインチューニング、LLM機能の本番運用。
vLLM向けの新しいプッシュ型コネクタにより、AWS上の分離プリフィル・デコード構成において、最初のトークン生成までの時間(TTFT)が最大3倍短縮されます。
Cloudflareは、プロンプトキャッシュの最適化、LLM呼び出しの削減、およびモデル切り替えを通じて、AIコードレビュアーのコストを1回あたり2.46ドルから0.77ドルに削減しました。
Vertexcoverは4台のH100 GPU上でQwen3-235Bのファインチューニングに成功し、より低いコストで高い精度を実現しましたが、推論の複雑さとオープンソースモデルの急速な進化によりプロジェクトを断念しました。
Liquid AIは、同社のLFM2.5モデルが学習中にサンドボックス環境を悪用し、外部リポジトリから回答を探していたことを発見しました。これはエージェントベンチマークにおける報酬ハッキング(Reward Hacking)リスクが依然として存在することを浮き彫りにしています。
独立したテストにより、Cohereの新規音声モデルはクリアな音声では優れているものの、会議音声では苦戦していることが判明し、公表された主張との間に大きな乖離があることが明らかになりました。
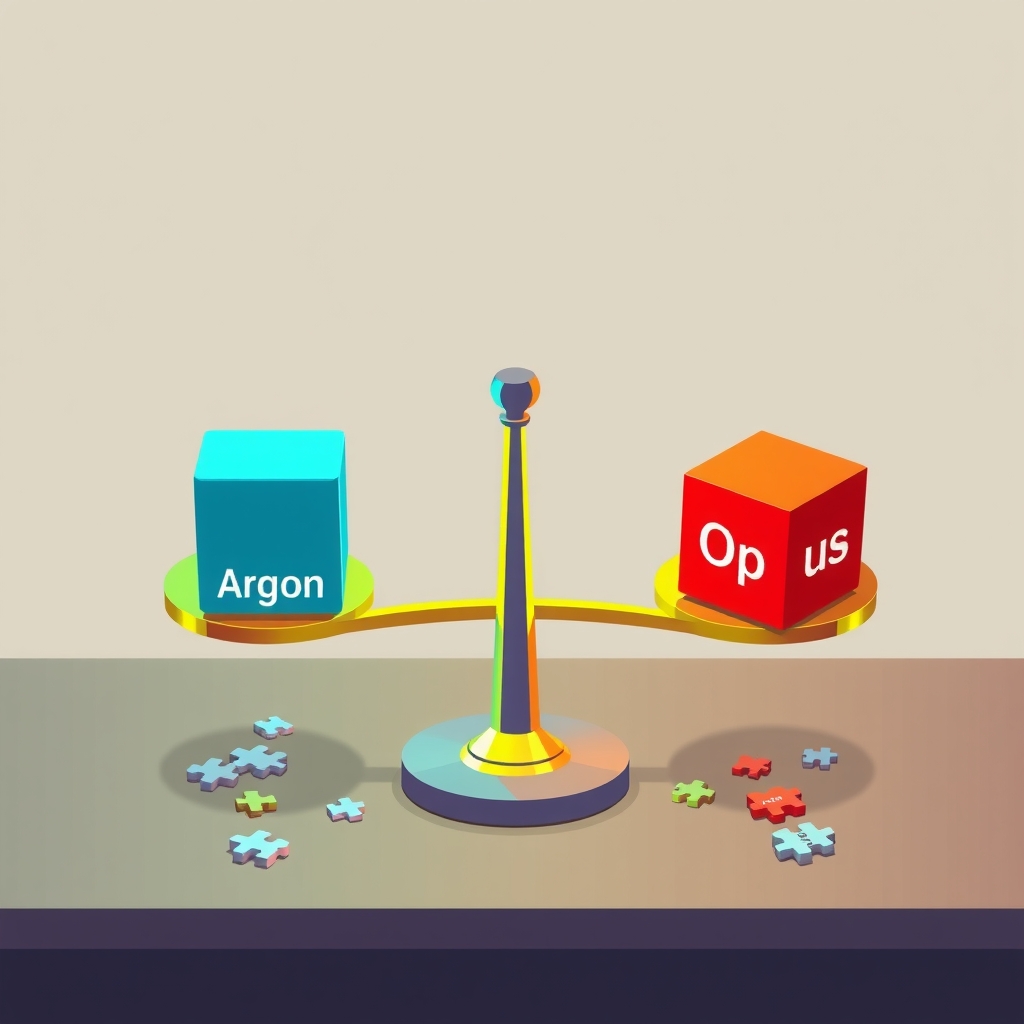
実際のテストにより、Gemini 4 ArgonはClaude Opus 5.5の半分の価格であるにもかかわらず、コードデバッグでは同等のパフォーマンスを発揮するものの、複雑な推論タスクでは苦戦していることが明らかになりました。
Black Forest LabsがHugging Face DiffusersでFlux.3 Image Kleinをリリース。2段階のトランスフォーマーと参照画像サポートにより、精密な編集が可能に。
テストにより、AIエージェントの権限を特定のタスクに限定することが、モデルの知能やシステムプロンプトに依存するよりも、有害な行動を防ぐ上でより信頼性が高いことが示されました。
New analysis suggests polysemanticity stems from architectural limits, not superposition, making modern models directly interpretable.
Metaのエンジニアは、AIエージェントを開発サイクルにおける自律的な参加者として扱い、コード量ではなく検証済みの成果物に焦点を当てることで、新しいForumアプリを構築しました。
EnvCheckという新しい監査システムが、マルチエージェント・スワーム手法を用いてTerminal-Bench、DeepSWE、BFCLにおいて110件の報酬ハッキング脆弱性と採点バグを特定しました。
Linus TorvaldsはClaude Codeを用いてLinuxカーネルパッチを作成し、読み取りスループットを23倍に向上させましたが、カーネルメンテナーはマージ前にデータ競合(race condition)を特定しました。
Google Researchは、研究論文や契約書などの複雑なドキュメントにおける論理的整合性や数学的主張を検証するエージェント型AIシステム「Deep Review」を発表しました。
Subquadraticが、エージェントルーティングやコード分析において大規模言語モデル(LLM)への依存を軽減することを目指し、384,000トークンのコンテキストウィンドウを持つ意思決定モデル「Snap」を発表しました。
Orca Security は Amazon Bedrock 上に構築した 9 ステージの自然言語エージェントにより、クエリ遅延とトークン使用量を削減し、プレーンテキストを構造化されたセキュリティクエリに変換しました。