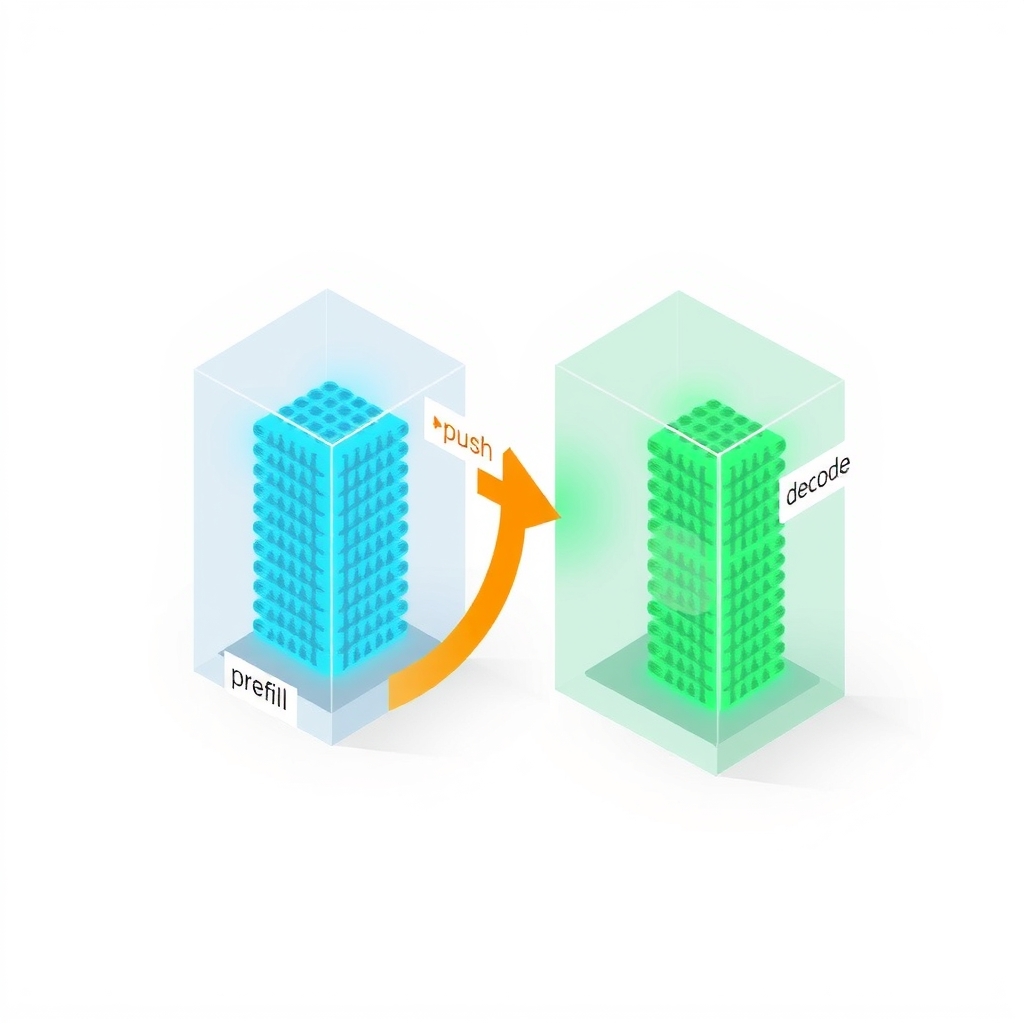
Cơ chế chuyển KV theo mô hình push của vLLM giúp giảm độ trễ trong suy luận phân tách
Một connector mới dựa trên cơ chế push cho vLLM giúp giảm thời gian phản hồi token đầu tiên (time-to-first-token) lên đến 3 lần trong các cấu hình prefill-decode phân tách trên AWS.