Kubernetes 1.32 introduit le streaming d'API pour corriger les pics de mémoire des requêtes list
Kubernetes 1.32 fait passer la fonctionnalité watch lists en bêta, permettant aux clients de diffuser en continu de grandes collections de ressources et d'éviter les plantages du serveur API dus à un manque de mémoire.
Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en décembre 2024, des ingénieurs d'Upbound, Google et Red Hat ont détaillé une amélioration cruciale de l'efficacité mémoire du serveur API Kubernetes. Cette mise à jour traite la manière dont les grands clusters gèrent la récupération massive de données, en introduisant un mécanisme de streaming qui empêche l'épuisement soudain de la mémoire sous forte charge.
Ce qui s'est passé
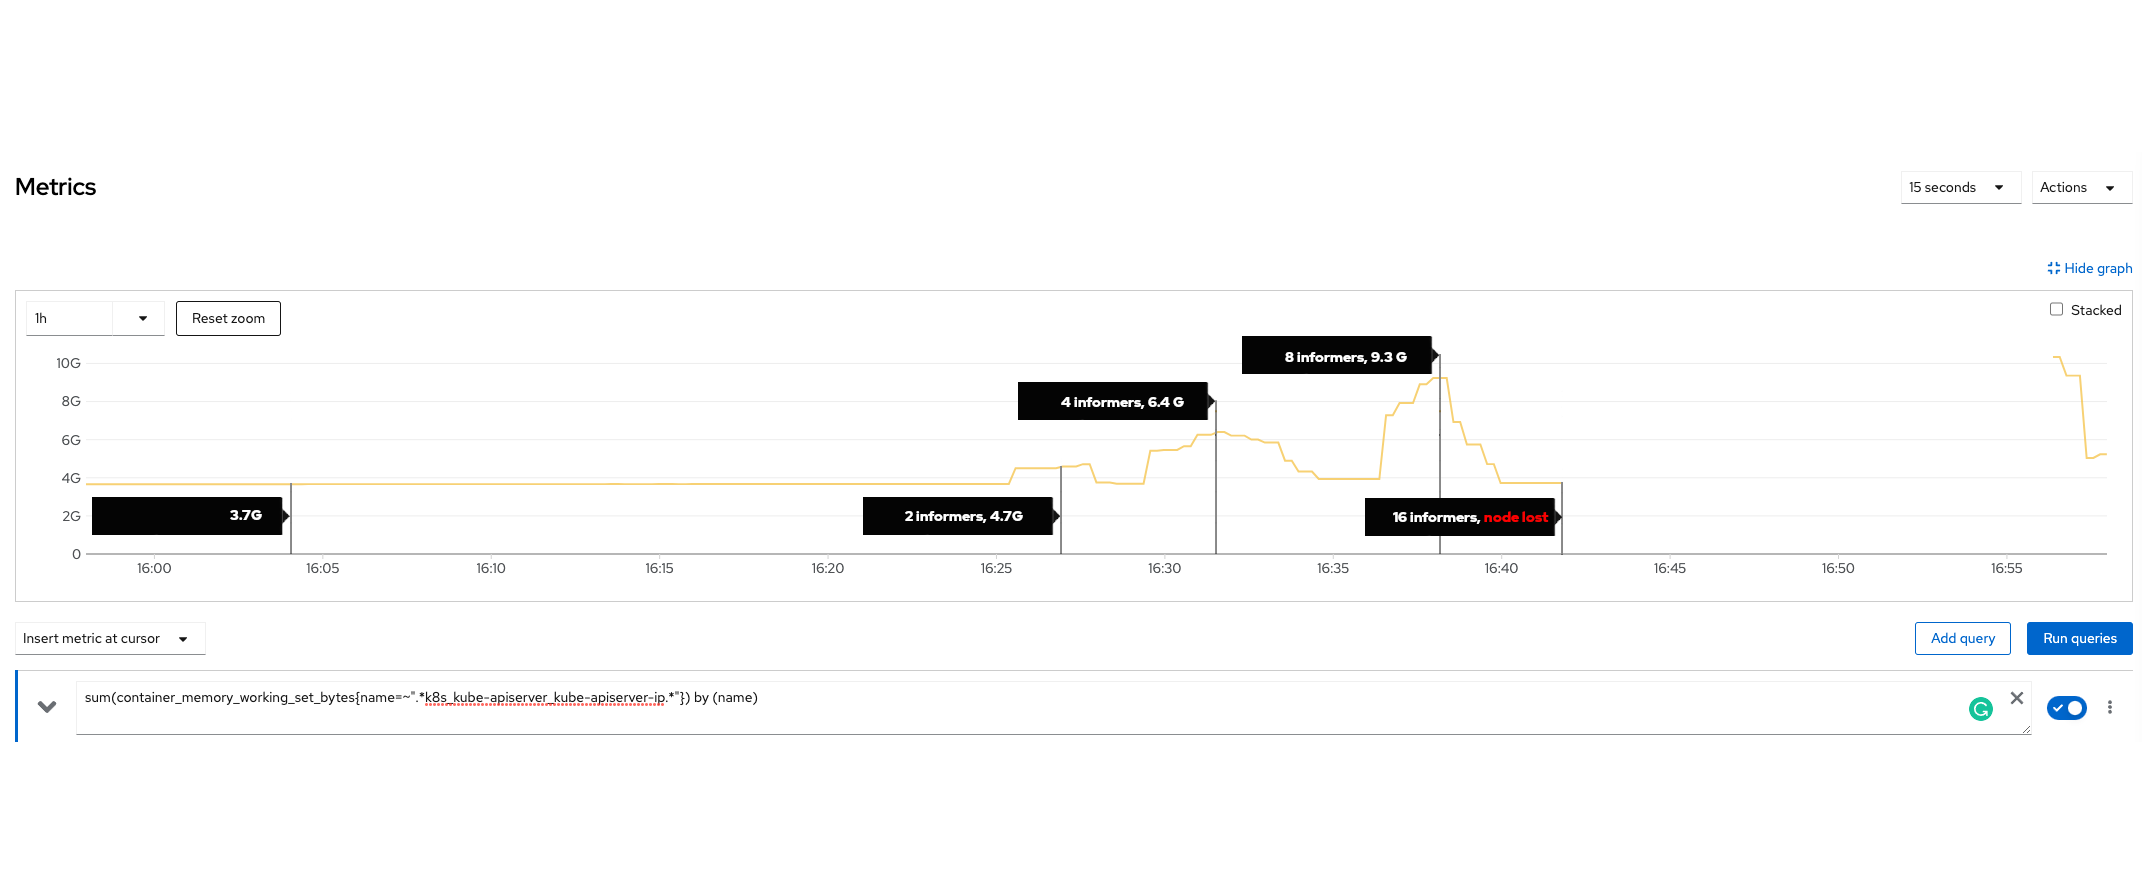
La gestion de grands clusters Kubernetes entraîne souvent une surcharge mémoire significative lorsque les composants émettent des requêtes list. Dans l'implémentation traditionnelle, le kube-apiserver doit assembler l'intégralité de la réponse en mémoire avant d'envoyer la moindre donnée au client. Si le corps de la réponse atteint plusieurs centaines de mégaoctets, ou si plusieurs requêtes arrivent simultanément après une panne réseau, ce processus peut rapidement consommer toute la RAM disponible. Bien que les mécanismes existants d'API Priority and Fairness protègent contre la surcharge CPU, ils offrent une protection limitée contre ces pics de mémoire non bornés.
L'investigation a révélé que cette allocation mémoire se produit parce que le serveur récupère les données depuis la base de données, les désérialise, puis construit le format final de la réponse en une seule fois. Cette séquence crée une empreinte mémoire temporaire massive que ni le ramasse-miettes de Go ni les limites mémoire configurées ne peuvent gérer efficacement lors de pics soudains. Dans les configurations à haute disponibilité, cela peut entraîner une défaillance en cascade où un serveur API plante en raison d'une condition d'out-of-memory (OOM), déplaçant les mêmes requêtes lourdes vers d'autres nœuds et provoquant leur échec également.
Pour résoudre ce problème, l'équipe Kubernetes a fait passer la fonctionnalité watch list en bêta dans la version 1.32. Cela permet aux clients d'activer le streaming des listes en passant des requêtes list standard à une forme spécialisée de requêtes watch. En servant ces requêtes depuis le watch cache, le serveur diffuse chaque élément individuellement plutôt que de mettre en tampon l'ensemble de la collection. Ce changement garantit que la surcharge mémoire reste constante, limitée uniquement par la taille maximale d'un objet unique plus quelques allocations mineures, améliorant considérablement la stabilité des clusters contenant de nombreux objets volumineux.
Comment cela fonctionne
Le mécanisme central repose sur le passage du traitement par lots au streaming. Les requêtes list traditionnelles obligent le serveur à conserver l'ensemble du jeu de données en RAM pendant la sérialisation. À l'inverse, la nouvelle approche watch list exploite le cache watch existant, qui est un cache en mémoire conçu pour faire évoluer les opérations de lecture. Lorsqu'un client utilise cette méthode, le serveur API envoie les objets un par un à mesure qu'ils sont récupérés depuis le cache, évitant ainsi la nécessité d'allouer de la mémoire pour le corps complet de la réponse en une seule fois.
Ce changement architectural découple l'utilisation mémoire du nombre total d'objets dans une collection. Au lieu que la consommation de mémoire croisse linéairement avec la taille de la liste, elle reste plate quel que soit le nombre d'éléments renvoyés. Cela rend le serveur API résilient même lorsqu'il traite des milliers de ressources volumineuses, telles que des Secrets avec des charges utiles substantielles, sans risque de kills OOM.
Détails clés
- La fonctionnalité watch list a atteint le statut bêta dans Kubernetes 1.32.
- Les clients doivent explicitement activer le feature gate
WatchListClientdans client-go pour utiliser le streaming des listes. - Des tests synthétiques ont montré que l'utilisation mémoire se stabilisait à 2 GB avec le streaming activé, contre 20 GB lorsqu'il était désactivé.
- La fonctionnalité nécessite les versions etcd 3.4.31+ ou 3.5.13+.
- Dans Kubernetes 1.33, de nouveaux feature gates
StreamingCollectionEncodingToJSONetStreamingCollectionEncodingToProtobufont été introduits pour le streaming côté serveur sans modifications client. - Le feature gate
WatchListest désactivé par défaut dans Kubernetes 1.33, bien qu'il ait été activé par défaut pour kube-controller-manager dans la version 1.32.
Pourquoi c'est important
Pour les ingénieurs plateforme et les SRE gérant des clusters à grande échelle, cette mise à jour adresse un point fragile de la stabilité du plan de contrôle. L'épuisement mémoire du serveur API est difficile à diagnostiquer et à récupérer, entraînant souvent des pannes complètes du plan de contrôle. En adoptant le streaming des listes, les équipes peuvent exécuter des clusters plus grands avec des ressources plus complexes sans craindre qu'une boucle de réconciliation routinière ou une synchronisation post-panne ne fasse planter leur couche de gestion.
Ce changement a également des implications sur la façon dont les coûts API sont calculés dans les futures versions. Actuellement, API Priority and Fairness attribue un coût faible aux requêtes list pour maintenir le parallélisme dans les cas d'usage typiques. À mesure que l'écosystème évolue vers les watch lists, le système peut augmenter en toute sécurité l'estimation du coût pour les requêtes list traditionnelles. Cela fournira une meilleure protection contre les clients hérités ou les outils mal configurés qui continuent d'émettre des requêtes massives coûteuses, assurant une distribution plus équitable des ressources à travers le cluster.
Ce que vous pouvez faire
- Mettez à niveau votre cluster vers Kubernetes 1.32 ou ultérieur pour accéder à la fonctionnalité bêta watch list.
- Vérifiez que votre version d'etcd est au moins la 3.4.31 ou la 3.5.13 pour assurer la compatibilité.
- Mettez à jour les clients basés sur Golang pour activer le feature gate
WatchListClientdans client-go. - Surveillez l'utilisation mémoire de vos serveurs API pendant les pics de charge afin d'identifier si les grandes requêtes list causent toujours des pics.
- Encouragez les contrôleurs tiers et les opérateurs présents dans votre environnement à adopter l'API de streaming durant la phase bêta.
- Préparez les futures mises à niveau vers Kubernetes 1.33 pour tirer parti des fonctionnalités d'encodage de streaming côté serveur qui ne nécessitent aucune modification du code client.



