Dynamische Kubernetes-APIs ohne eigene Controller erstellen
Ingenieure von Cozystack erklären, wie sie die Aggregationsebene der Kubernetes-API nutzten, um dynamische imperativ ausgerichtete Endpunkte zu erstellen und die Speicherbeschränkungen von etcd zu umgehen.
Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Kubernetes Blog vom November 2024 erläuterte Andrei Kvapil von Ænix, wie sein Team einen dynamischen Extension-API-Server für Cozystack entwickelt hat. Der Artikel behandelt die technische Implementierung der Aggregationsebene der Kubernetes-API und stellt diese den Standard-Custom Resource Definitions (CRDs) sowie Operatoren gegenüber.
Was passiert ist
Kvapil erklärte, dass sich die meisten Kubernetes-Erweiterungen zwar auf CRDs und Controller stützen, dieser Ansatz jedoch bei bestimmten Anwendungsfällen an Grenzen stößt. Standard-Operatoren sind zwar hervorragend in der deklarativen Abstimmung des Zustands, haben aber Schwierigkeiten mit imperativer Logik, Echtzeit-Datengenerierung oder komplexen Validierungsanforderungen. Um diese Lücken zu schließen, implementierte das Cozystack-Team einen eigenen Extension-API-Server, der über die Aggregationsebene direkt in das Kubernetes-API-Framework integriert wird.
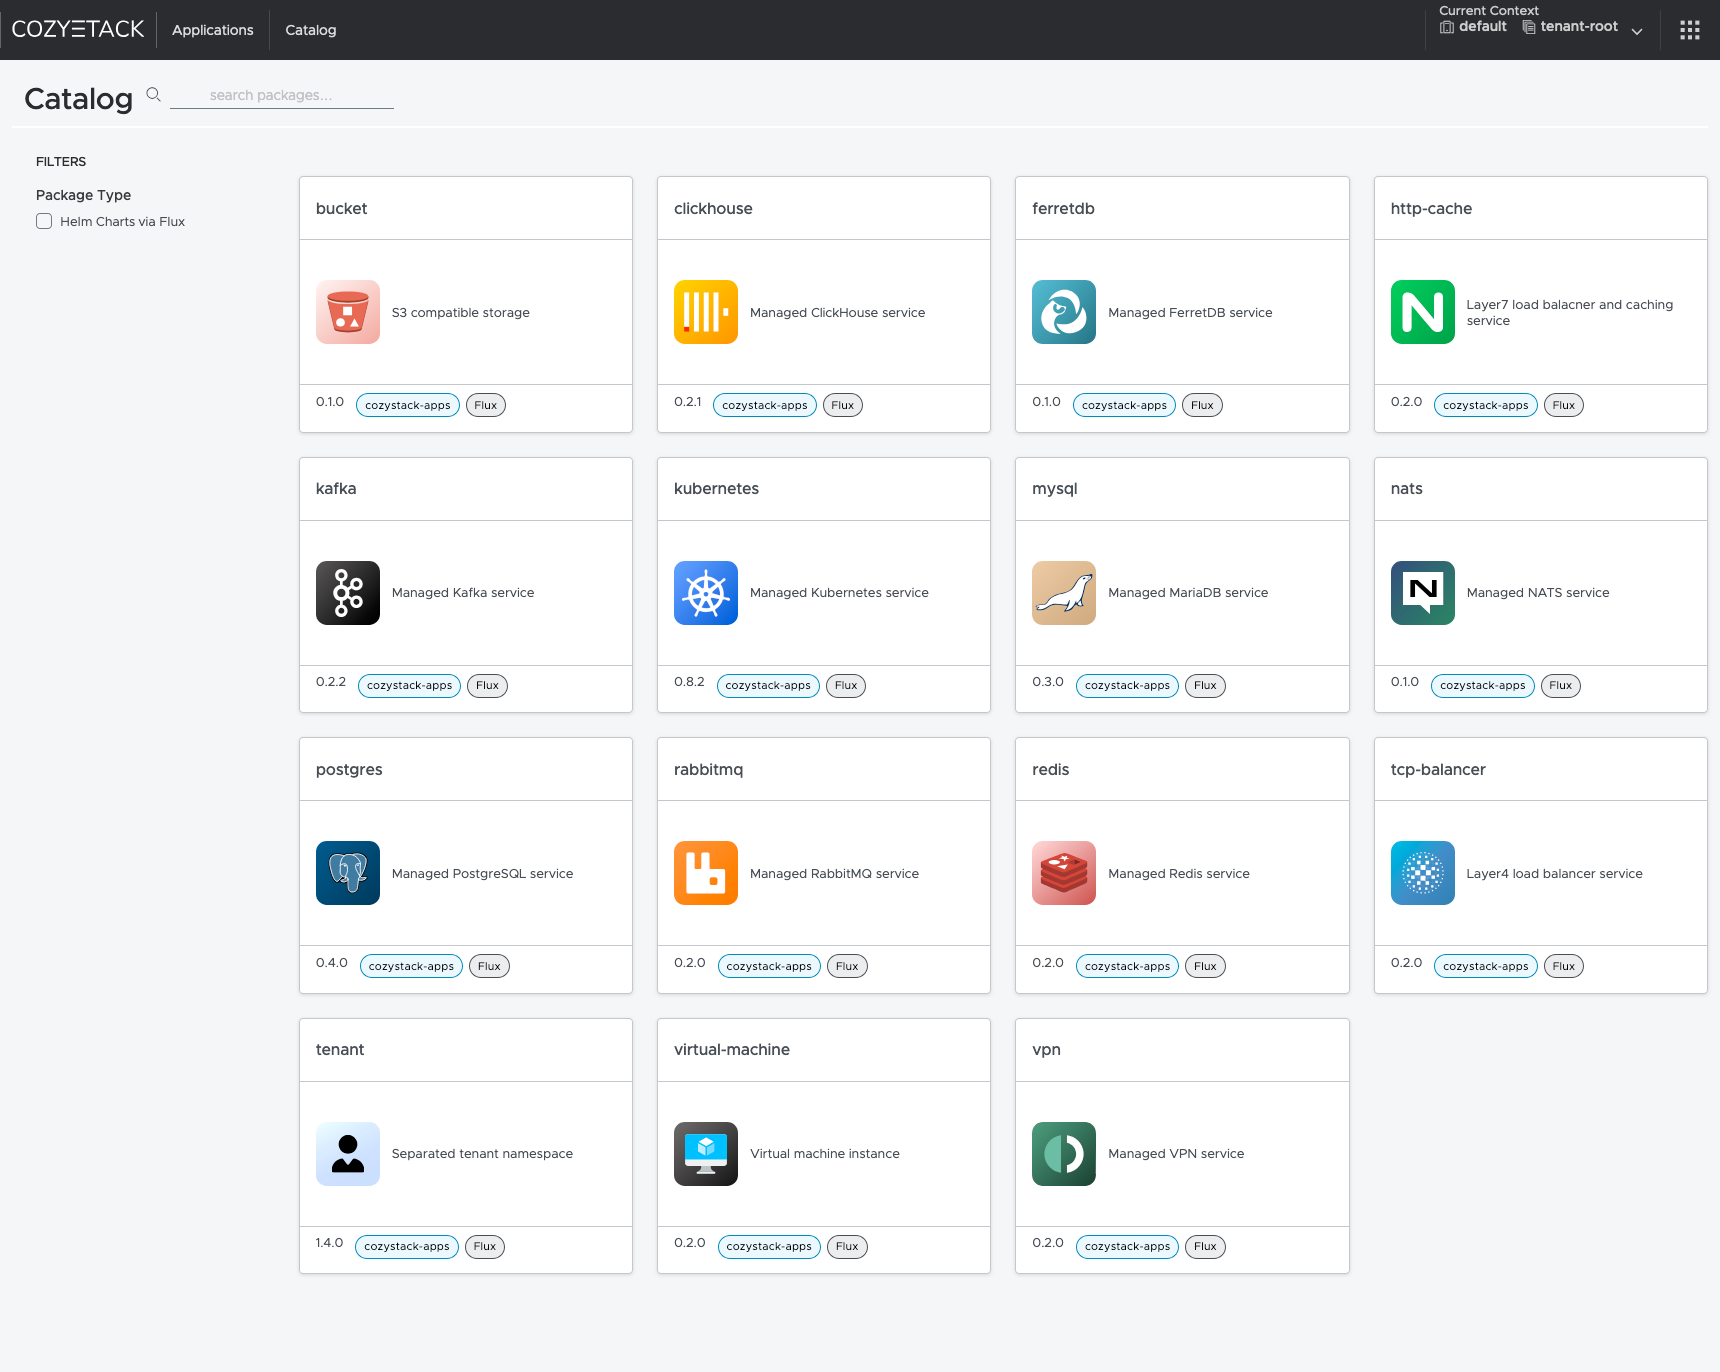
Der Kern dieser Implementierung besteht darin, ein APIService-Objekt innerhalb des Clusters zu registrieren. Diese Registrierung weist den primären Kubernetes-API-Server an, Anfragen für bestimmte Ressourcengruppen an den externen Extension-Server weiterzuleiten. Für Cozystack ermöglichte dies die dynamische Bereitstellung neuer Ressourcentypen basierend auf verfügbaren Helm-Charts, ohne dass Codeänderungen oder Neukompilierungen erforderlich waren. Das System bildet benutzerfreundliche Typen wie Postgres oder Redis direkt auf die zugrunde liegenden Helm-Releases ab und abstrahiert so die Komplexität für Endbenutzer.
Dieser Ansatz löste auch erhebliche RBAC-Herausforderungen. Die standardmäßige rollenbasierte Zugriffssteuerung (Role-Based Access Control) von Kubernetes kann Listenvorgänge nicht nach Labels oder spezifischen Spec-Feldern filtern, sondern nur nach Ressourcennamen. Indem Cozystack für jeden Servicetyp eigenständige Ressourcentypen generierte, konnte es native RBAC-Richtlinien nutzen, um den Zugriff präzise einzuschränken. Darüber hinaus übernimmt der Extension-Server die bidirektionale Konvertierung zwischen den neuen benutzerdefinierten Typen und den internen HelmRelease-Ressourcen, was die Abwärtskompatibilität mit bestehenden Dashboards und Tools sicherstellt.
Wie es funktioniert
Die Aggregationsebene der API fungiert als Proxy innerhalb der Kubernetes-Control-Plane. Wenn ein Benutzer eine Anfrage an die Kubernetes-API für eine Ressourcengruppe sendet, die von einer Erweiterung bedient wird, leitet der primäre API-Server diese Anfrage an den Extension-API-Server weiter. Dieser Server arbeitet unabhängig von den Komponenten der primären Control-Plane und kann seine eigene Geschäftslogik, Validierung und Speichermechanismen implementieren.
Im Gegensatz zu Standard-Controllern, die den Zustand in etcd synchronisieren, kann ein Extension-API-Server Antworten dynamisch erzeugen. Dies ähnelt der Funktionsweise des metrics-server, der Echtzeitdaten von Kubelets abruft, anstatt sie zu speichern. Im Fall von Cozystack entdeckt der Server dynamisch verfügbare Dienste und registriert sie als API-Ressourcen. Er validiert Eingaben, konvertiert sie in HelmRelease-Objekte und übermittelt sie an den Cluster, wobei eine klare Trennung zwischen der benutzerseitigen API und der internen Implementierung beibehalten wird.
Wichtige Details
- Die Aggregationsebene der API ermöglicht es Extension-Servern, imperative Logik und Subressourcen wie
/execoder/logzu verarbeiten. - Extension-APIs werden über ein
APIService-Objekt registriert, das den Datenverkehr für bestimmte API-Gruppen an den externen Server leitet. - Im Gegensatz zu CRDs müssen Extension-Server ihren Zustand nicht in etcd speichern, was Echtzeit-Datengenerierung und reduzierten Speicheraufwand ermöglicht.
- Cozystack nutzt dieses Modell, um Servicetypen wie
Postgresdynamisch auf zugrunde liegende Helm-Charts abzubilden, ohne den Code neu kompilieren zu müssen. - Die Implementierung unterstützt komplexe serverseitige Validierungen und benutzerdefinierte Tabellenformatierungen, die über die Möglichkeiten von CRDs hinausgehen.
- Instabile Extension-Server können das Löschen von Namespaces blockieren oder API-Latenzen verursachen; daher ist Zuverlässigkeit entscheidend.
Warum das wichtig ist
Für Plattform-Ingenieure eröffnet das Verständnis der Aggregationsebene Designmuster, die mit CRDs allein schwierig oder unmöglich umzusetzen sind. Es ermöglicht die Erstellung von APIs, die sich wie native Kubernetes-Ressourcen verhalten, aber mit imperativer Logik oder externen Backends arbeiten. Dies ist besonders nützlich für die Integration von Legacy-Systemen, die Bereitstellung von Echtzeit-Metriken oder die Erstellung vereinfachter Schnittstellen für komplexe Anwendungen.
Diese Leistungsfähigkeit bringt jedoch operative Risiken mit sich. Wenn ein Extension-API-Server nicht verfügbar ist, kann dies die Leistung des gesamten Clusters beeinträchtigen. Vorgänge wie das Löschen von Namespaces können hängen bleiben, während sie auf die Bestätigung der Ressourcenbereinigung durch die Erweiterung warten. Ingenieure müssen den Nutzen eines benutzerdefinierten API-Verhaltens gegen die zusätzliche Komplexität und potenzielle Stabilitätsauswirkungen beim Betrieb zusätzlicher API-Server abwägen.
Was Sie tun können
- Prüfen Sie, ob Ihr Anwendungsfall imperative Logik oder Echtzeitdaten erfordert, bevor Sie sich zwischen CRDs und einer Extension-API entscheiden.
- Verwenden Sie
kubectl get apiservices, um die aktuell in Ihrem Cluster registrierten Aggregationsebenen zu inspizieren. - Implementieren Sie robuste Health Checks und Timeouts für jeden Extension-API-Server, um clusterweite Blockaden zu verhindern.
- Nutzen Sie die Aggregationsebene für Subressourcen wie Logs oder Exec-Proxies, wo Standard-CRUD-Operationen nicht anwendbar sind.
- Erwägen Sie den Einsatz von Extension-Servern, um externe Datenbanken oder Dienste als native Kubernetes-Ressourcen bereitzustellen, um das Management zu vereinfachen.
- Testen Sie Fehler-Szenarien gründlich, insbesondere das Löschen von Namespaces und die API-Discovery, um die Cluster-Stabilität sicherzustellen.



