MLXでMac Studioクラスタを使い、1兆パラメータ規模のLLMを実行
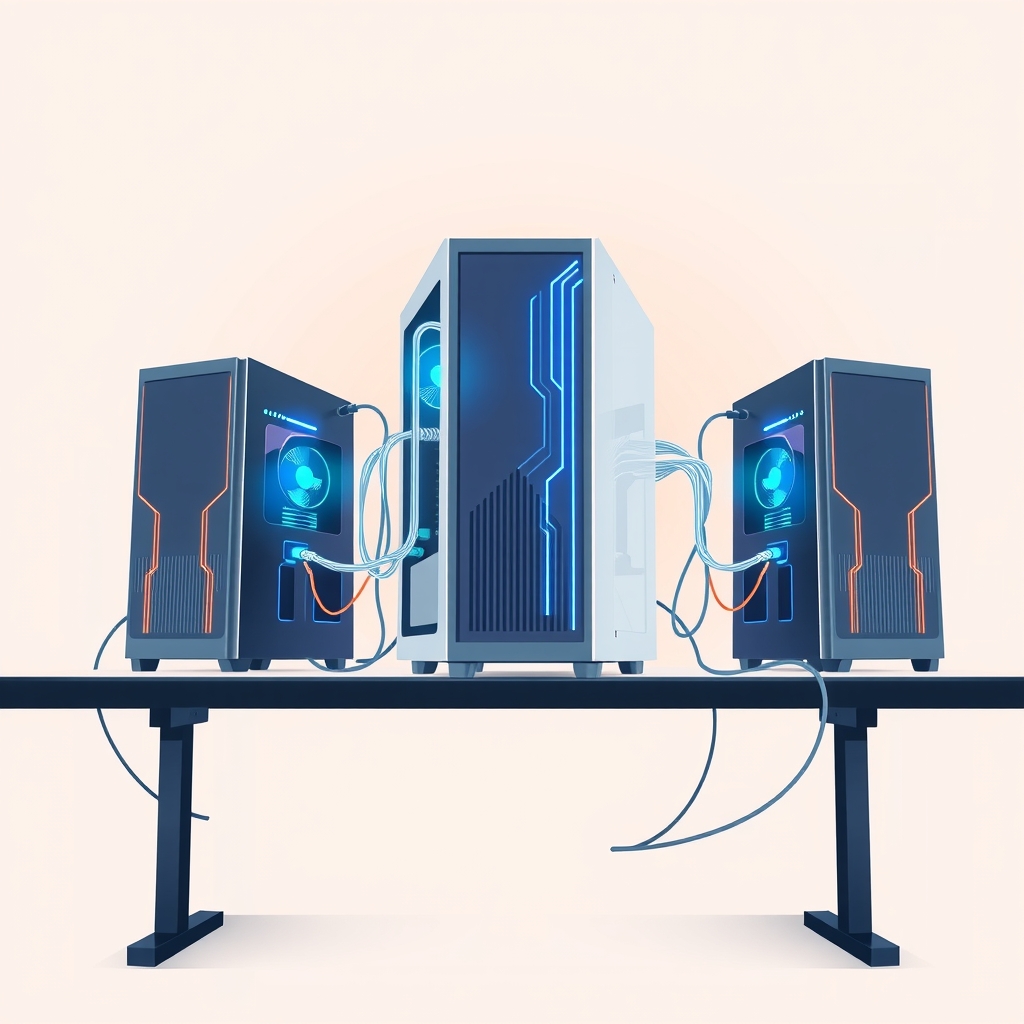
Appleの研究チームは、MLXとThunderbolt経由のRDMAを用いて、816Bパラメータを持つ「Muse Spark Open」モデルを4台のMac Studioで実行する方法を実証しました。
AI、開発者向けツール、インフラのデイリーカバー。各記事では、何が起こり、なぜ重要なのかを解説し、元の出典へのリンクを提供します。
Appleの研究チームは、MLXとThunderbolt経由のRDMAを用いて、816Bパラメータを持つ「Muse Spark Open」モデルを4台のMac Studioで実行する方法を実証しました。
Speculative decoding lets large language models verify multiple token guesses in a single forward pass, reducing memory-bound latency without changing output distribution.
Kubernetesプロジェクトは、生成AIワークロードのルーティングを標準化し、レイテンシの削減とGPU利用率の向上を実現する「Gateway API Inference Extension」をリリースしました。