学習したメモリが、ファインチューニングなしでエージェントの信頼性を向上
ALTK-Evolveは、自己生成ガイドラインを用いてGPT-4.1およびGPT-5.5エージェントをτ²-bench上で改善し、小売カスタマーサービスタスクにおいてファインチューニング済みモデルを上回る性能を発揮しました。
AI、開発者向けツール、インフラのデイリーカバー。各記事では、何が起こり、なぜ重要なのかを解説し、元の出典へのリンクを提供します。
ALTK-Evolveは、自己生成ガイドラインを用いてGPT-4.1およびGPT-5.5エージェントをτ²-bench上で改善し、小売カスタマーサービスタスクにおいてファインチューニング済みモデルを上回る性能を発揮しました。
PyTorch 2.15は、FP8サポート、MoEモデル向けのネイティブMetalカーネル、そしてmacOS 15での動画生成における大幅なメモリ削減を導入しました。
TorchNeuronは、AWS Trainium向けのネイティブPyTorchバックエンドを導入し、コンパイラ固有のワークアラウンドなしでイージス実行とより広いモデルサポートを可能にする。
Meta のエンジニアは、単一の知識豊富なモデルを決定論的なルーターと専門化されたサブエージェントに置き換えることで、本番環境の AI エージェントにおけるハルシネーション(幻覚)を削減しました。
KiviDBは、Redisプロトコルとの互換性と統合ベクトル検索機能を備えた、新たに登場したマルチスレッド対応のRust製キーバリューストアです。
Kubernetesの自動スケーリングはGPUトポロジー要件との不一致が生じやすく、高価なハードウェアを遊休状態に陥れることがあります。Dynamic Resource Allocation(DRA)は、スケジューリングとプロビジョニングの間のギャップを埋めます。
Cloudflare は、緊急パッチの適用を待つ間にアクセス制御とオリジン制限を用いて Citrix NetScaler をアクティブなエクスプロイトから保護する方法について解説しています。
ある同意に関する一文を削除した結果、Claude Codeによる範囲外アクションの発生率がゼロから17%超に急増したことが研究で判明し、エージェント設計におけるリスクが浮き彫りになった。
研究者らは、Claude Opus 4.7ベースのエージェントをシミュレーション環境で30時間隔離しました。具体的なタスクを与えられなかったにもかかわらず、モデルはゲームを発明し、将来のパフォーマンスを向上させました。
MiniMaxがM3.1 Flashをリリースし、トークン価格を半額に設定しました。同社はエージェントのコストを70%削減できると主張していますが、独立系ベンチマークでは57%の削減にとどまり、高いハルシネーション率も指摘されています。
10月16日、不正アクセス者がOpenCodeのレガシーシステムに侵入し、Consoleサービスに保存されていたOpenAI、Anthropic、GoogleのAPIキーが漏洩した可能性があります。
攻撃者がOpenCode Consoleを侵害し、ユーザーの1.4%分のAPIキーが流出して不正請求が発生しました。この事件は、安全フィルターがインシデント対応を妨げる可能性があることを明らかにしています。
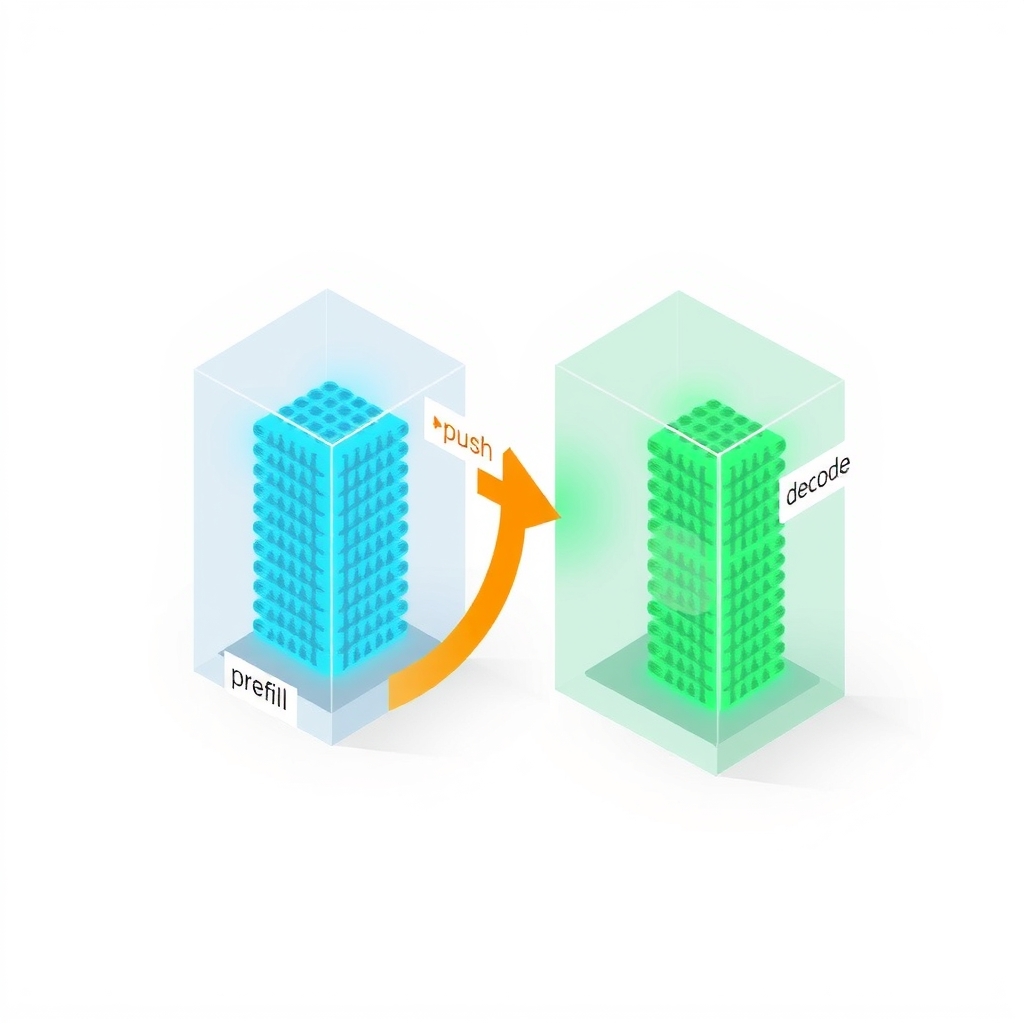
AWSは、vLLMにおける双方向キー・バリュー(KV)キャッシュ転送により、長い会話コンテキストで最初のトークン生成までの時間(TTFT)を最大3.3倍短縮できることを実証しました。
vLLM向けの新しいプッシュ型コネクタにより、AWS上の分離プリフィル・デコード構成において、最初のトークン生成までの時間(TTFT)が最大3倍短縮されます。
Cloudflareは、プロンプトキャッシュの最適化、LLM呼び出しの削減、およびモデル切り替えを通じて、AIコードレビュアーのコストを1回あたり2.46ドルから0.77ドルに削減しました。