Meta étend LLDB avec un plugin neutre pour le débogage GPU
Des ingénieurs de Meta ont introduit une nouvelle architecture de plugin accélérateur dans lldb-server qui unifie les sessions de débogage CPU et GPU tout en gardant la logique spécifique au matériel séparée.
Traduit automatiquement depuis l'original anglais.
Le 9 novembre 2026, des ingénieurs de Meta ont publié les détails d'une nouvelle architecture pour le débogueur LLDB, simplifiant le diagnostic des applications fonctionnant à la fois sur les unités centrales (CPU) et les processeurs graphiques (GPU). Cette mise à jour introduit un système de plugins neutre vis-à-vis du fournisseur au sein de lldb-server, permettant aux développeurs d'inspecter le code hôte et le code périphérique dans une seule session sans fusionner des modèles d'exécution incompatibles.
Ce qui s'est passé
Les charges de travail modernes en intelligence artificielle basculent fréquemment l'exécution entre le code de haut niveau des frameworks sur le CPU et les noyaux spécialisés sur le GPU. Lorsque des erreurs surviennent lors de ces transitions, les outils de débogage traditionnels éprouvent des difficultés car ils supposent un processus unique avec un seul jeu d'instructions et un espace mémoire unique. Historiquement, les fournisseurs matériels comme AMD et NVIDIA proposaient leurs propres débogueurs dédiés, tels que ROCgdb et CUDA-GDB, nécessitant une maintenance séparée et offrant peu de support pour un flux de travail unifié.
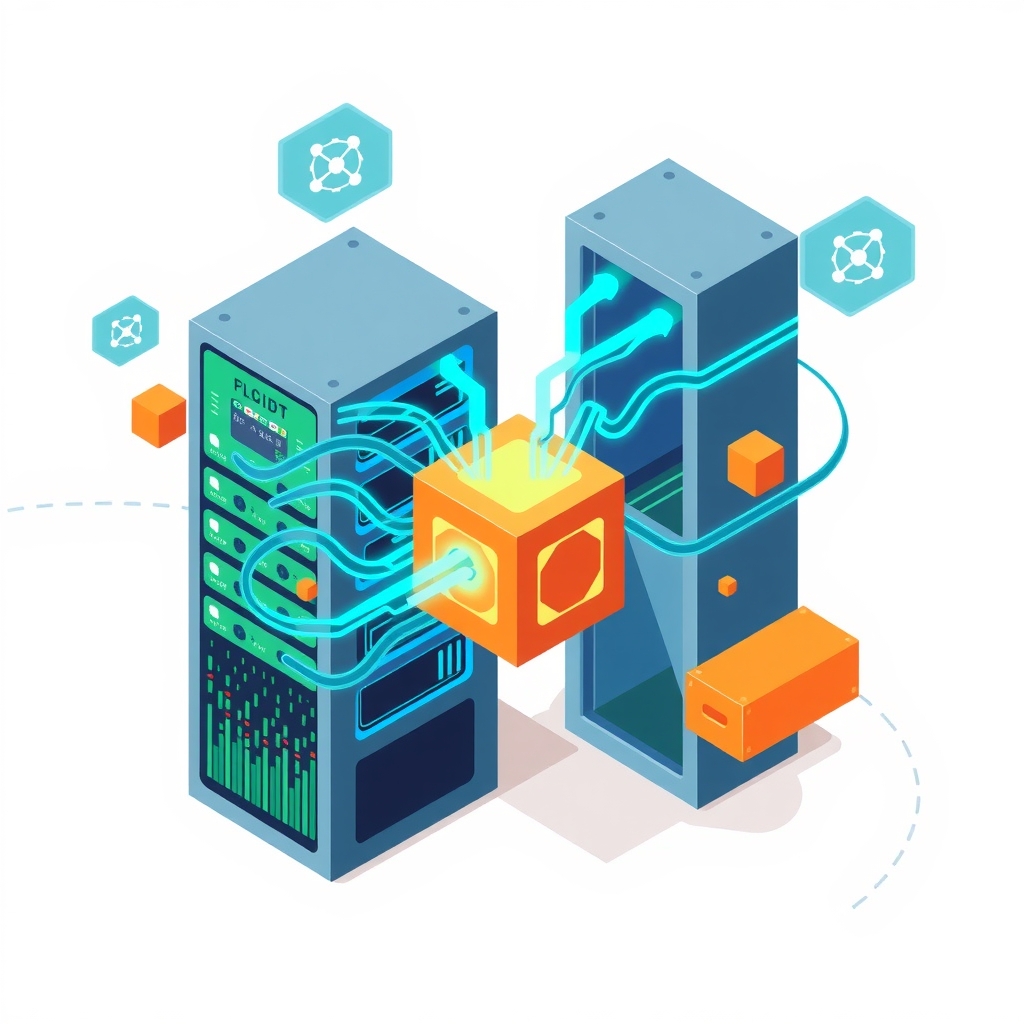
Pour remédier à cette fragmentation, Meta a développé une architecture de plugin accélérateur intégrée à lldb-server. Cette conception sépare l'infrastructure partagée du débogueur de la logique de contrôle spécifique au matériel requise par différents GPU. Cette approche permet au client LLDB principal de rester ignorant des détails spécifiques aux fournisseurs, tandis qu'un plugin backend traduit les API spécifiques aux périphériques en concepts standards de débogage. Ces travaux ont évolué grâce aux contributions de Meta et de l'écosystème plus large des accélérateurs, visant à fournir une interface cohérente indépendamment du matériel sous-jacent.
L'équipe a intégré la majeure partie de ce framework commun au projet LLVM. Cela inclut l'interface de plugin pour lldb-server, de nouveaux paquets GDB-remote pour la coordination, ainsi que le support de plusieurs espaces d'adressage. Un plugin accélérateur fictif a également été créé pour permettre le test des flux de découverte et de connexion sans nécessiter de matériel GPU physique, garantissant que l'infrastructure peut être validée indépendamment de tout périphérique spécifique.
Comment cela fonctionne
L'innovation principale réside dans la manière dont le système représente le CPU et le GPU. Au lieu de les forcer dans un modèle de processus artificiel unique, l'architecture les traite comme deux cibles LLDB distinctes. Chaque cible maintient ses propres threads, registres et carte mémoire, reflétant la réalité qu'un pointeur comme 0x1000 peut faire référence à des emplacements complètement différents dans la mémoire hôte et celle du périphérique. Le CPU continue d'utiliser le chemin standard de débogage natif, tandis que le GPU est géré via une seconde connexion établie par le plugin.
La coordination se fait par une séquence structurée d'événements. Lorsque LLDB se connecte à lldb-server, il découvre les plugins accélérateurs disponibles. Le plugin peut demander des points d'arrêt internes dans le processus hôte pour détecter l'initialisation du runtime GPU. Une fois que l'hôte atteint un tel point d'arrêt, le plugin active l'API de débogage spécifique au fournisseur et crée un point de terminaison de connexion. LLDB génère alors une seconde cible pour l'accélérateur, permettant au développeur de basculer entre les contextes de manière transparente. Cette méthode garantit que les opérations telles que la lecture de mémoire ou la définition de points d'arrêt sont toujours dirigées vers le domaine matériel correct.
Détails clés
- L'architecture utilise une interface de plugin neutre vis-à-vis du fournisseur dans lldb-server pour gérer la logique spécifique au matériel.
- Le CPU et le GPU sont représentés comme des cibles LLDB séparées avec des architectures et des espaces d'adressage indépendants.
- Le support ne s'active que lorsqu'un runtime GPU pris en charge est détecté, n'ajoutant aucune surcharge aux applications uniquement CPU.
- Un plugin fictif permet de tester le flux de coordination sans matériel GPU physique.
- La majeure partie du framework commun, y compris les paquets GDB-remote et le support multi-adresses, est désormais intégrée à LLVM.
- La conception prend en charge à la fois les sessions de débogage en direct et l'analyse post-mortem via les dumps cœur GPU.
Pourquoi c'est important
Pour les ingénieurs logiciels développant des systèmes d'IA, ce changement réduit la friction liée au débogage des applications hybrides. Auparavant, suivre un bug traversant la frontière CPU-GPU nécessitait souvent de changer d'outil ou de mapper mentalement des états disjoints. En présentant les deux domaines dans une seule interface, les développeurs peuvent définir des points d'arrêt dans le code hôte qui déclenchent l'inspection des noyaux périphériques, maintenant le contexte tout au long de l'investigation. Cette vue unifiée est cruciale à mesure que les modèles deviennent plus complexes et que les mouvements de données entre l'hôte et le périphérique augmentent.
Du point de vue de la maintenance des outils, la séparation des responsabilités offre des avantages significatifs à long terme. Les fournisseurs matériels n'ont plus besoin de reconstruire des fonctionnalités communes de débogage, comme la gestion des symboles ou l'intégration IDE, pour chaque nouveau périphérique. Ils peuvent se concentrer uniquement sur l'implémentation du plugin qui traduit leurs jeux de registres et modèles d'exécution spécifiques dans les abstractions standard de LLDB. Cette modularité signifie que les améliorations apportées au cœur du débogueur profitent automatiquement à tous les accélérateurs pris en charge, réduisant la duplication des efforts dans l'industrie.
Ce que vous pouvez faire
- Mettez à jour vos installations LLVM et LLDB vers des versions incluant la nouvelle interface de plugin accélérateur.
- Si vous maintenez un pilote ou un runtime GPU, explorez l'implémentation du backend de plugin spécifique au fournisseur pour activer le support LLDB.
- Utilisez le plugin accélérateur fictif pour tester vos flux de travail de débogage et vérifier la logique de coordination sans dépendance matérielle.
- Configurez votre IDE pour reconnaître plusieurs cibles LLDB si vous déboguez des applications déléguant des tâches à des accélérateurs.
- Consultez les spécifications des paquets GDB-remote intégrées pour comprendre comment la découverte et l'initialisation des plugins sont gérées.
- Fournissez des retours à la communauté LLVM sur l'architecture des plugins pour aider à façonner les futures intégrations fournisseurs.